접두사 트리 또는 트라이(영어: trie)는 문자열을 간결하게 저장하기 위한 트리 형태의 자료 구조로, 정점 사이의 간선에는 문자가 기록되어 있고 일부 정점은 종단 정점으로 표시되어 있습니다.
루트에서 $v$까지의 경로 위에 있는 모든 글자를 차례로 적었을 때 문자열 $s$가 되는 터미널 정점 $v$가 존재하면, 접두사 트리가 문자열 $s$를 받아들인다고 합니다.
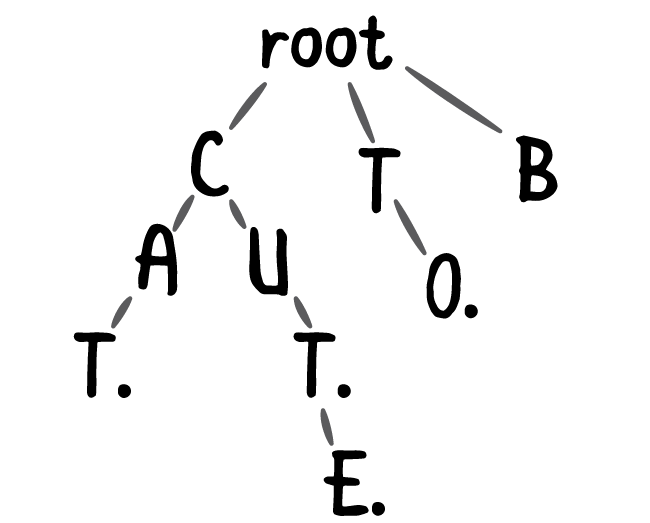
트라이 자체만으로도 다양한 문제에 사용할 수 있습니다:
- 문자열 저장: 반복되는 긴 접두사가 많다면 트라이는 문자열 배열이나
set보다 훨씬 적은 공간을 차지할 수 있습니다. - 문자열 정렬: 구축한 트라이를
dfs로 순회하면 모든 문자열을 사전순으로 출력할 수 있습니다. - 단순히 문자열의 집합으로도 사용할 수 있습니다. 앞으로 보겠지만, 트라이에는 단어를 쉽게 추가하고 삭제할 수 있으며 포함 여부도 쉽게 검사할 수 있습니다.
오토마타 이론의 관점에서 보면, 각 정점은 상태이고, 올바른 한 글자 추가는 모두 오토마톤의 올바른 전이입니다. 따라서 트라이는 단어가 집합에 속하는지를 검사하는 오토마톤입니다.
#구현
접두사 트리는 서로를 참조하는 정점들의 형태로 저장하는 것이 가장 간단합니다. 각 정점에는 보통 그 정점이 종단 정점인지 여부, 자식에 대한 참조, 그리고 문제에 따라 달라지는 추가 정보가 저장됩니다. 예를 들어 멀티셋을 구현하려면 해당 정점에서 끝나는 단어의 개수를 저장할 수 있습니다.
라틴 알파벳(소문자 26개)의 경우, 처음에 비어 있는 트라이는 다음과 같이 구현할 수 있습니다:
const int k = 26;

struct Vertex {
    Vertex* to[k] = {0}; // нулевой указатель означает, что перехода нет
    bool terminal = 0;
};

Vertex *root = new Vertex();
트라이에 단어를 추가하려면 루트에서 시작하여 단어의 문자를 따라 이동해야 합니다. 다음 문자에 대한 전이가 없으면 전이를 생성하고, 그렇지 않으면 이미 존재하는 전이를 따라 이동합니다. 마지막에는 현재 상태를 종료 상태로 표시하는 것을 잊지 말아야 합니다.
void add_string(string &s) {
    v = root;
    for (char c : s) {
        c -= 'a'; // получаем число от 0 до 25
        if (!v->to[c])
            v->to[c] = new Vertex();
        v = v->to[c];
    }
    v->terminal = true;
}
단어가 트라이에 있는지 확인하려면, 마찬가지로 루트에서부터 단어의 문자를 따라 이동해야 합니다. 마지막에 종단 정점에 도달했다면 단어가 있는 것입니다. 비종단 정점에 도달했거나 도중에 존재하지 않는 링크를 따라가야 했다면 단어가 없는 것입니다.
bool find(string &s) {
    v = root;
    for (char c : s) {
        c -= 'a';
        if (!v->to[c])
            return false;
        v = v->to[c];
    }
    return v->terminal;
}
단어는 「게으르게」 삭제할 수 있습니다. 즉, 해당 단어까지 내려간 뒤 종단 플래그만 제거하면 됩니다.
bool erase(string &s) {
    v = root;
    for (char c : s)
        v = v->to[c - 'a'];
    v->terminal = false;
}
문제에 따라 이 절차들을 수정해야 할 때도 있습니다. 예를 들어 자동 완성, 즉 쿼리가 주어지면 주어진 접두사를 가진 모든 단어를 찾는 기능을 구현하려 한다면, 종단 정점으로 이어지지 않는 정점을 조심스럽게 삭제할 수 있습니다. 그러면 쿼리에 답할 때 접두사에 해당하는 상태에서 dfs로 순회하면서 모든 종단 정점에서 답을 출력하기만 하면 됩니다.
#링크를 저장하는 방법
때로는 제약 조건 때문에 자식에 대한 링크를 단순히 배열에 저장할 수 없습니다.
예를 들어 알파벳이 크다면, 대부분이 비어 있을 그 많은 배열을 초기화하기에는 시간도 메모리도 부족합니다.
포인터 배열 외에도 문자에서 링크로의 매핑을 저장하는 방법은 여러 가지가 있습니다:
- 동적 배열(
std::vector), - 이진 트리(
std::map), - 해시 테이블(
std::unordered_map).
대부분의 경우 메모리가 실제로 가장 중요하게 고려해야 할 사항입니다. 또한 64비트 시스템에서는 new와 포인터를 사용하는 대신 모든 것을 큰 배열이나 벡터에 할당하고, 8바이트짜리 메모리 포인터 대신 4바이트짜리 정점 인덱스를 저장하는 것이 유리할 수 있습니다.
#디지털 트라이
일부 문제에서는 문자열처럼 트라이에 수를 저장하는 아이디어가 등장하는데, 이러한 구조를 디지털 트라이라고 합니다.
대부분의 경우 수는 이진법으로 기록하면 되고, 그러면 모든 것이 매우 간단하지만, 어떤 문제에서는 다른 진법이 필요하기도 합니다. 그런데 예를 들어 십진법에서는 수를 사전순으로 비교할 수 없습니다(2 > 11). 이 문제를 없애기 위해 모든 수가 10의 어떤 거듭제곱보다 작다고 가정하고, 수 앞에 0을 채워 넣기만 하면 됩니다. 이제 02 < 11입니다.
문제. 어떤 수의 집합이 주어지고, 세 종류의 쿼리에 답해야 합니다:
- 수 $x$를 추가합니다.
- 수 $x$를 삭제합니다.
- 배열에서 $x$와의
xor이 최대가 되는 수 $y$를 찾습니다.
처음 두 종류의 쿼리는 이미 디지털 트라이에서 처리할 수 있지만, 세 번째 유형의 쿼리는 더 어렵습니다.
만약 집합에 $y_i \neq x_i$인(즉, $i$번째 비트에서 서로 다른) $y$가 존재한다면, $i$번째 비트까지(포함)의 접두사가 $x$의 접두사와 같은 다른 어떤 수보다도 그 $y$를 택하는 것이 더 이득이라는 점에 주목하십시오. 그러한 수와 $x$의 xor는 $i$번째 비트보다 낮은 비트만을 포함하게 되므로, 우리가 이미 $y$로 얻을 수 있는 $2^i$를 넘을 수 없기 때문입니다.
그러면 세 번째 유형의 쿼리에 답할 때 트라이를 따라 탐욕적으로 내려가면서, 매번 $i$번째 비트가 $x_i$와 같지 않은 가지로 가려고 시도할 수 있습니다.