접미사 배열, 접미사 오토마톤, 접미사 트리를 통틀어 접미사 자료구조라고 부릅니다. 이들은 올림피아드와 실무 양쪽에서 접하는 다양한 문제 집합에 활용됩니다.
접미사 구조는 흔히(항상 그런 것은 아니지만) 서로 대체할 수 있으며, 더 나아가 선형 시간에 서로 변환할 수 있습니다. 접미사 배열은 그중 가장 단순한 구조이므로, 이것부터 시작하겠습니다.
#동기
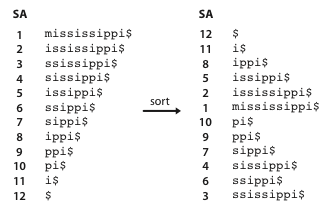
문자열 $s$의 접미사 배열(영어: suffix array, суфмасс)은 $s$의 접미사들의 시작 인덱스를 사전순으로 정렬한 순열입니다. 다시 말해, 접미사 배열을 만들려면 주어진 문자열의 모든 접미사를 정렬해야 합니다.
이것이 유용할 수 있는 경우. 여러분이 또 하나의 검색 엔진을 창업하려 하고, 투자를 받으려면 최소한으로라도 동작하는 무언가를 만들어야 한다고 합시다. 적어도 키워드로 그 키워드를 포함하는 문서들과 그 등장 위치를 찾을 수 있어야 합니다(90년대였다면 이것만으로도 꽤 강력한 MVP였을 것입니다). 단순한 알고리즘들, 즉 다항식 해시, z-함수와 접두사 함수, 심지어 아호-코라식으로도 이를 빠르게 할 수는 없습니다. 매번 모든 데이터를 훑어야 하기 때문입니다. 하지만 접미사 구조로는 가능합니다.
접미사 배열의 경우에는 다음과 같이 할 수 있습니다. 모든 문서 문자열을 알파벳에 속하지 않는 어떤 구분자($)와 함께 이어 붙이고, 이에 대해 접미사 배열을 구축한 다음, 각 쿼리마다 이진 탐색으로 접미사 배열에서 찾는 단어보다 작은 첫 번째 접미사와 작은 마지막 접미사를 찾습니다. 이 두 접미사 사이에 있는 모든 접미사는 찾는 문자열을 접두사로 포함합니다.
예를 들어, 예시의 접미사 배열에서 문자열 iss는 접미사 issippi$와 ississippi$ 사이에 놓이게 되는데, 이 접미사들의 인덱스는 $2$와 $5$이므로, 바로 이 위치들에서 원본 텍스트에 등장하게 됩니다.
이러한 알고리즘은 $O(|t| \log |s|)$에 동작하며, 나중에 이를 $O(|t| + \log |s|)$까지 최적화할 수 있는데, 이는 가장 최적의 탐색 알고리즘 중 하나입니다.
이제 이것을 구축하는 방법을 알아봅시다.
#접미사 배열 구축
접미사를 정렬하려면 $0$부터 $n$까지의 순열을 만들고, 해당 인덱스의 접미사끼리 비교하는 비교자를 작성해서 std::sort에 넘기기만 하면 됩니다. 이 방법은 내부 비교가 $O(n)$에 동작하므로 $O(n^2 \log n)$에 동작합니다. 하지만 접미사를 해시로 비교하면 $O(n \log^2 n)$ 알고리즘을 얻을 수 있습니다. 그러나 이것이 가장 빠르고 편리한 알고리즘은 아닙니다.
#$O(n \log n)$ 구성
편의를 위해 문자열 끝에 다른 어떤 문자보다도 사전순으로 작은 문자를 하나 덧붙입시다. 표준 ASCII의 경우 보통 «$»나 «#»을 선택하거나, C-string이라면 그냥 널 문자를 사용합니다(C 언어에서는 모든 문자열이 원래 널 문자로 끝납니다).
우리는 접미사가 아니라 순환 이동을 정렬할 것입니다. 이에 따라 문자열도 순환 문자열로 간주할 것입니다. 이렇게 하면 모든 문자열의 길이가 같아진다는 점에서 편리합니다. 이러한 순환 이동을 정렬하는 것이 접미사를 정렬하는 것과 동등하다는 것은 쉽게 확인할 수 있습니다. 달러 기호 뒤에 오는 것을 모두 지우기만 하면 됩니다.
우리의 알고리즘은 $\lceil \log n \rceil$개의 단계로 구성됩니다. $k$번째 단계에서는 길이가 $2^k$인 모든 순환 부분 문자열을 정렬합니다. 따라서 마지막 단계에서는 길이가 $\geq n$인 문자열을 정렬하게 되며(문자열이 순환이므로 이는 문제가 없습니다), 이로써 원하는 접미사 배열을 얻게 됩니다.
접미사 정렬과 달리 부분 문자열 정렬은 항상 유일하게 정해지지는 않는다는 점에 주목하십시오. 두 부분 문자열이 서로 같을 수 있기 때문입니다. 따라서 알고리즘의 각 단계에서는 순환 부분 문자열 인덱스의 순열 $p$와 함께, 각 순환 부분 문자열이 속한 동치류의 번호 $c_i$도 유지하겠습니다. 동치류 번호는 순서를 보존하도록 부여하겠습니다. 즉, 사전순으로 더 작은 부분 문자열에는 더 작은 $c_i$가 대응합니다. 마지막 단계가 끝나면 동치류 배열은 접미사 배열의 역순열이 되어야 합니다.
예: $s = aaba$. 단계는 3개입니다: 길이가 1, 2, 4인 부분 문자열에 대한 단계입니다.
$$ p_0 = (0, 1, 3, 2) \;\;\; c_0 = (0, 0, 1, 0) \\ p_1 = (0, 3, 1, 2) \;\;\; c_1 = (0, 1, 2, 0) \\ p_2 = (3, 0, 1, 2) \;\;\; c_2 = (1, 2, 3, 0) $$진정한 프로그래머답게 우리는 단계에 0부터 번호를 매기므로, 0번째 단계에서는 길이가 $2^0 = 1$인 문자열, 즉 그냥 문자들을 정렬합니다. 알파벳이 작다면 계수 정렬로 $O(n)$에 쉽게 할 수 있습니다.
이후 단계는 이전 단계의 정보를 이용하여 수행해야 합니다. 처음 풀이에서처럼, 다시 인덱스의 순열을 만들고 여기에 직접 정의한 비교자로 std::sort를 적용할 수 있습니다.
$2^{k-1}$ 크기의 두 부분 문자열을 빠르게 비교하기 위해, 길이 $2^k$인 각 문자열에 바이그램, 즉 두 개의 «문자»로 이루어진 문자열을 대응시켜 동치류 $c_i$를 사용할 수 있습니다. 즉, 문자열 $s[i \ldots i+2^k-1]$은 정렬의 관점에서 쌍 $(c_i, c_{i+2^{k-1}})$과 동등합니다. 따라서 이 쌍만 살펴보며 문자열을 선형으로 훑는 대신 $O(1)$에 동작하는 비교자를 작성할 수 있습니다. 그러나 각 단계가 $O(n \log n)$에 동작하므로, 이 방법은 여전히 $O(n \log^2 n)$에 동작합니다.
참고. 이 구성 방법은 상수가 작아서 대체로 빠르게 동작합니다.
각 단계를 선형 시간으로 최적화하려면 정렬에서 로그 인자를 없애야 합니다. 병합 정렬은 정렬하는 값에 대해 아무것도 모를 때에만 최적입니다. 하지만 우리의 경우는 그렇지 않습니다.
기수 정렬의 아이디어를 활용합시다. 먼저 바이그램을 두 번째 문자 기준으로 정렬한 다음, 첫 번째 문자 기준으로 정렬합니다. 이전 단계에서 우리는 이미 두 번째 원소들의 순서를 알고 있습니다(이것이 바로 배열 $p$입니다). 이제 이들을 첫 번째 원소 기준으로 정렬하려면, 이 순서대로 접미사들을 훑으면서 각 원소의 시작 위치에서 $2^{k-1}$을 빼 시작 인덱스를 구한 뒤 기수 정렬을 수행하기만 하면 됩니다. 따라서 각 단계를 $O(n)$에, 전체 알고리즘을 $O(n \log n)$에 수행할 수 있습니다.
// строка -- это последовательность чисел от 1 до размера алфавита
vector<int> suffix_array(vector<int> &s) {
    s.push_back(0);  // добавляем нулевой символ в конец строки
    int n = (int) s.size(),
        cnt = 0,  // вспомогательная переменная: счётчик для сортировки
        cls = 0;  // количество классов эквивалентности
    vector<int> c(n), p(n);

    map<int, vector<int>> t;
    for (int i = 0; i < n; i++)
        t[s[i]].push_back(i);

    // «нулевой» этап
    for (auto &x : t) {
        for (int u : x.second)
            c[u] = cls, p[cnt++] = u;
        cls++;
    }

    // пока все суффиксы не стали уникальными
    for (int l = 1; cls < n; l++) {
        vector< vector<int> > a(cls);  // массив для сортировки подсчётом
        vector<int> _c(n);  // новые классы эквивалентности
        int d = (1 << l) / 2;
        int _cls = cnt = 0;  // новое количество классов

        for (int i = 0; i < n; i++) {
            int k = (p[i] - d + n) % n;
            a[c[k]].push_back(k);
        }

        for (int i = 0; i < cls; i++) {
            for (size_t j = 0; j < a[i].size(); j++) {
                // если суффикс начинает новый класс эквивалентности
                if (j == 0 || c[(a[i][j] + d) % n] != c[(a[i][j - 1] + d) % n])
                    _cls++;
                _c[a[i][j]] = _cls - 1;
                p[cnt++] = a[i][j];
            }
        }

        c = _c;
        cls = _cls;
    }

    return vector<int>(p.begin() + 1, p.end());
}
저자는 코드의 품질에 대해 양해를 구하며, 독자 여러분께 코드를 다시 작성하여 기여해 주시기를 권합니다.
#최장 공통 접두사
많은 응용에서 문자열의 여러 접미사에 대해 최장 공통 접두사(영어: largest common prefix)의 길이를 구할 수 있으면 유용한 경우가 많습니다.
예를 들어, 단순히 두 부분 문자열을 비교하려면, 대응하는 접미사들의 가장 긴 공통 접두사를 찾은 뒤 그다음 문자를 보면 됩니다. 이는 보통 해시로 하는 방식과 같습니다.
명제. 접미사 배열에서 서로 이웃한 모든 접미사에 대해 lcp를 알고 있다고 합시다. 이는 길이가 $(n - 1)$인 어떤 배열이 됩니다. 그러면 $i$번째 접미사와 $j$번째 접미사의 공통 접두사는 배열 lcp에서 $c_i$번째 원소와 $c_j$번째 원소 사이의 최솟값과 같습니다(다시 말하면 동치류인 $c_i$는 접미사 배열에서 $i$번째 접미사의 번호입니다).
증명을 위해 lcp 배열을 히스토그램 형태로 나타낼 수 있습니다. $c_i$와 $c_j$ 사이 구간의 최솟값은 이 두 접미사와 가장 짧은 공통 접두사를 가지는 접미사에 해당하며, 따라서 이 접두사까지의 모든 문자, 그리고 오직 그 문자들만이 최장 공통 접두사가 됩니다.
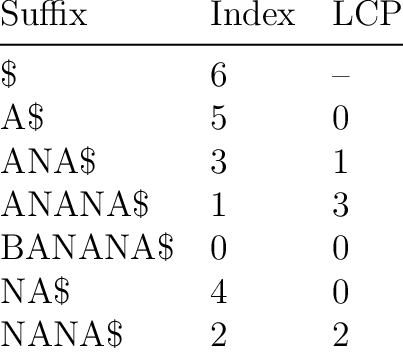
그러면 이웃한 접미사들의 최장 공통 접두사를 담은 배열 lcp$를 계산하고, 그다음 이 배열에서 어떻게든 구간 최솟값을 구하려는 동기가 생깁니다(예를 들어 희소 테이블을 사용할 수 있습니다).
이제 lcp 배열을 빠르게 계산하는 방법을 고안하는 일만 남았습니다. $O(n \log^2 n)$ 접미사 배열 구성에서 사용한 아이디어를 활용할 수 있습니다. 즉, 해시와 이진 탐색을 이용하여 각 이웃 쌍에 대해 lcp를 구하는 것입니다. 이 방법은 $O(n \log n)$에 동작하지만, 가장 편리하거나 널리 쓰이는 방법은 아닙니다.
#카사이, 아리무라, 아리카와, 이, 박의 알고리즘
이 알고리즘은 실제로는 원래 방식이 아닌 온갖 이름으로 불립니다(Kasai 알고리즘, 다섯 한국인의 알고리즘 등). $lcp$를 선형 시간에 계산하는 데 사용됩니다. 저자가 보기에 이 알고리즘은 아이디어 면에서 Z 함수와 어딘가 비슷합니다.
명제. 이미 접미사 배열을 구성하고 $lcp[i]$를 계산했다고 합시다. 그러면 다음이 성립합니다.
$$ lcp[c[p[i] + 1]] \ge lcp[i] - 1 $$쉽게 말하면: 원래 문자열에서 다음 접미사의 $lcp$는 많아야 1만큼 작습니다.
증명. $p[i]$번째 접미사가 $p[i + 1]$번째 접미사와 길이 $lcp[i]$의 공통 부분을 가졌다면, $(p[i] + 1)$번째 접미사는 $(p[i + 1] + 1)$번째 접미사와 길이 $(lcp[i] - 1)$의 공통 부분을 반드시 가지게 됩니다.
이 접미사가 반드시 접미사 배열에서 $(p[i] + 1)$번째 접미사의 이웃이 되는 것은 아니지만, 임의의 두 접미사에 대한 $lcp$의 성질로부터 $lcp[c[p[i] + 1]] \ge lcp[i] - 1$임을 얻습니다. 여기서 $lcp$의 정확한 값은 단순히 나이브한 방법으로, 즉 늘어나는 동안 계속 늘려 가며 계산하되, 그 시작값은 이 부등식에 근거하여 정한다는 아이디어가 떠오릅니다. 이 경우 불필요한 비교를 하지 않기 위해 $lcp$ 배열도 긴 접미사에서 짧은 접미사 순서로 계산하겠습니다.
알고리즘 코드:
    vector<int> calc_lcp(vector<int> &val, vector<int> &c, vector<int> &p) {
        int n = val.size();
        int l = 0; // lcp текущего элемента
        vector<int> lcp(n);
        for (int i = 0; i < n; i++) {
            if (c[i] == n - 1)
                continue;
            int nxt = p[c[i] + 1];
            while (max(i, nxt) + l < n && val[i + l] == val[nxt + l])
                l++;
            lcp[c[i]] = l;
            l = max(0, l - 1);
        }
        return lcp;
    }
알고리즘의 시간 복잡도를 평가하기 위해, 단순하게 1을 더하는 연산을 몇 번 수행하는지 세어 봅시다. 각 $lcp[i] \le n$이며, 또한 전이할 때 1을 빼는 연산은 최대 $n$번 수행합니다. 따라서 더하는 연산의 총 횟수는 $O(n)$입니다. 그러므로 알고리즘 자체도 $O(n)$에 동작합니다.