다익스트라 알고리즘(영어: Dijkstra’s algorithm)은 음수 가중치 간선이 없는 그래프에서 주어진 정점 $s$로부터 다른 모든 정점까지의 최단 경로를 찾습니다.
이 알고리즘에는 두 가지 주요 변형이 있으며, 각각의 실행 시간은 $O(n^2)$과 $O(m \log n)$입니다. 여기서 $n$은 정점의 수이고 $m$은 간선의 수입니다.
#기본 아이디어
배열 $d$를 만들고, 각 정점 $v$에 대해 $s$에서 $v$까지의 최단 경로의 현재 길이 $d_v$를 저장하겠습니다. 처음에는 $d_s = 0$이고, 나머지 모든 정점에 대해서는 거리가 무한대(또는 가능한 최대 거리보다 확실히 큰 임의의 수)입니다.
알고리즘이 실행되는 동안 우리는 정점까지의 더 최적인 경로를 찾아 거리를 줄여 나가면서 이 배열을 점차 갱신할 것입니다. 어떤 정점 $v$까지 찾은 경로가 최적이라는 것을 알게 되면, 처음에 0으로 채워진 특별한 배열 $a$에 1을 넣어($a_v=1$) 그 정점을 표시할 것입니다.
알고리즘 자체는 $n$번의 반복으로 이루어지며, 각 반복에서는 아직 표시되지 않은 정점 중 $d_v$ 값이 가장 작은 정점 $v$를 선택합니다:
$$ v = \argmin_{u | a_u=0} d_u $$(첫 번째 반복에서는 시작 정점 $s$가 선택된다는 점에 유의하십시오.)
선택된 정점은 배열 $a$에 표시되고, 그다음 정점 $v$에서 완화를 수행합니다. 즉, 나가는 모든 간선 $(v,u)$를 살펴보면서 각 정점 $u$에 대해 다음과 같은 대입을 수행하여 $d_u$ 값을 개선하려고 시도합니다.
$$ d_u = \min (d_u, d_v + w) $$여기서 $w$는 간선 $(v, u)$의 길이입니다.
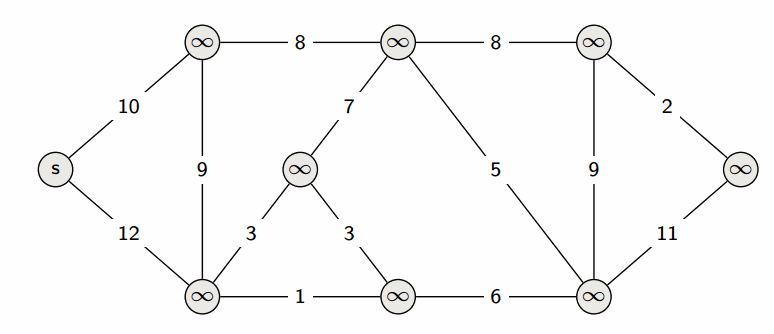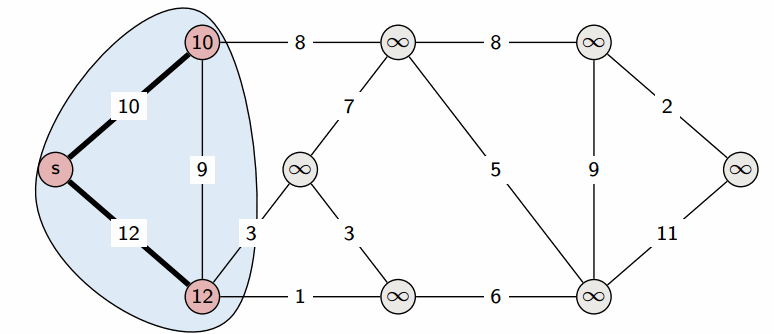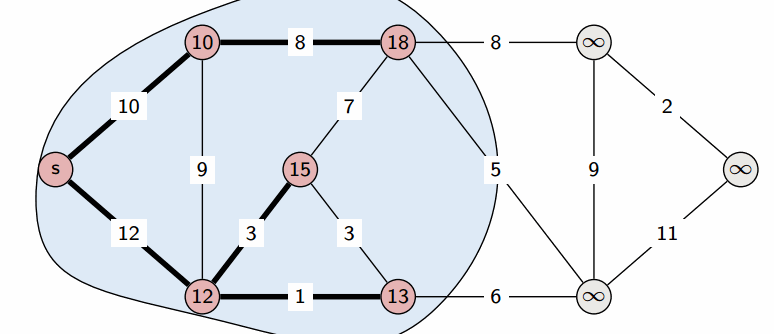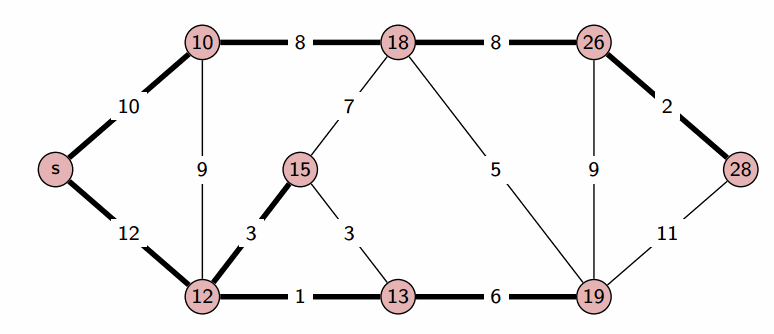
이로써 현재 반복이 끝나고, 알고리즘은 다음 반복으로 넘어갑니다. 다시 $d$ 값이 가장 작은 정점을 선택하고, 그 정점에서 완화를 수행하는 과정을 반복합니다. $n$번의 반복이 끝나면 그래프의 모든 정점이 표시된 상태가 되고, 알고리즘은 작업을 마칩니다.
#정확성
정점 $s$에서 $v$까지의 거리를 $l_v$로 나타냅시다. 알고리즘이 끝났을 때 모든 정점에 대해 $d_v = l_v$임을 보여야 합니다(도달할 수 없는 정점은 예외이며, 이러한 정점의 거리는 모두 무한대로 남습니다).
먼저, 임의의 정점 $v$에 대해 항상 $d_v \ge l_v$가 성립한다는 점에 주목합시다. 알고리즘은 존재하는 모든 경로 중 가장 짧은 경로보다 더 짧은 경로를 찾을 수 없습니다(우리는 완화 외에는 아무것도 하지 않았기 때문입니다).
알고리즘 자체의 정당성 증명은 다음 명제에 근거합니다.
명제. 어떤 정점 $v$가 표시된 이후에는 그 정점까지의 현재 거리 $d_v$가 이미 최단 거리이며, 따라서 더 이상 변하지 않습니다.
증명은 귀납법으로 진행합니다. 첫 번째 반복에 대해서는 그 타당성이 자명합니다. 정점 $s$에 대해 $d_s=0$이며, 이것이 바로 그 정점까지의 최단 경로의 길이입니다.
이제 이 명제가 이전의 모든 반복, 즉 이미 표시된 모든 정점에 대해 성립한다고 가정합시다. 현재 반복을 수행한 후에도 이 명제가 깨지지 않음을, 즉 선택된 정점 $v$에 대해 그 정점까지의 최단 경로의 길이 $l_v$가 실제로 $d_v$와 같음을 증명하겠습니다.
정점 $v$까지의 임의의 최단 경로를 살펴봅시다. 이 경로 위에서 표시되지 않은 첫 번째 정점을 $y$, 그 바로 앞에 있는 표시된 정점을 $x$라고 합시다(정점 $s$는 표시되어 있고 정점 $v$는 표시되어 있지 않으므로 이러한 정점들은 반드시 존재합니다). 간선 $(x, y)$의 가중치를 $w$라고 합시다.
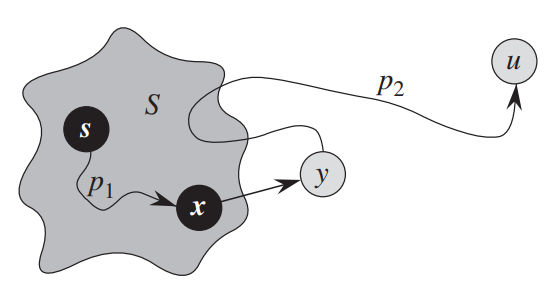
$x$는 표시된 정점이므로, 귀납 가정에 의해 $d_x = l_x$입니다. $(x,y)$가 최단 경로 위에 있으므로 $l_y=l_x+w$이며, 이는 정확히 $d_y=d_x+w$와 같습니다. 어느 시점에 이미 표시된 정점 $x$에서 완화를 수행했기 때문입니다.
그렇다면 $y \ne v$인 경우가 있을 수 있겠습니까? 그렇지 않습니다. 우리는 매 반복마다 $d_v$가 가장 작은 정점을 선택하며, 경로상에서 $y$보다 뒤에 있는 정점은 모두 $s$로부터의 거리가 더 크기 때문입니다. 따라서 $v = y$이고, $d_v = d_y = l_y = l_v$이므로 증명이 끝납니다.
#실행 시간과 구현
알고리즘에서 복잡도를 좌우하는 유일한 가변적인 부분은 $d_v$가 최소인 $v$를 구체적으로 어떻게 찾느냐입니다.
#밀집 그래프의 경우
$m \approx n^2$이라면, 매 반복마다 단순히 배열 전체를 훑어서 $\argmin d_v$를 찾으면 됩니다.
const int maxn = 1e5, inf = 1e9;
vector< pair<int, int> > g[maxn];
int n;

vector<int> dijkstra(int s) {
    vector<int> d(n, inf), a(n, 0);
    d[s] = 0;
    for (int i = 0; i < n; i++) {
        // находим вершину с минимальным d[v] из ещё не помеченных
        int v = -1;
        for (int u = 0; u < n; u++)
            if (!a[u] && (v == -1 || d[u] < d[v]))
                v = u;
        // помечаем её и проводим релаксации вдоль всех исходящих ребер
        a[v] = true;
        for (auto [u, w] : g[v])
            d[u] = min(d[u], d[v] + w);
    }
    return d;
}
이러한 알고리즘의 점근 복잡도는 $O(n^2)$입니다: 각 반복마다 $O(n)$ 시간에 argmin을 찾고 $O(n)$번의 완화를 수행합니다.
또한 $n$번이 아니라 그보다 약간 적은 횟수의 반복만 수행해도 된다는 점에 주목합시다. 첫째, 마지막 반복은 아예 수행하지 않아도 됩니다(그 정점에서는 더 이상 아무것도 완화할 수 없기 때문입니다). 둘째, 도달할 수 없는 정점($d_v = \infty$)에 이르면 그 즉시 종료해도 됩니다.
#희소 그래프의 경우
$m \approx n$이면 최솟값을 더 빠르게 찾을 수 있습니다. 선형 탐색 대신 원소를 추가하고 최솟값을 찾을 수 있는 자료구조를 하나 둡시다. 예를 들어 std::set이 이런 기능을 제공합니다.
이 구조에는 $(d_v, v)$ 쌍을 유지합시다. 완화할 때는 기존의 $(d_u, u)$를 삭제하고 새로운 $(d_v + w, u)$를 추가하며, 최적의 $v$를 찾을 때는 단순히 최솟값(첫 번째 원소)을 가져옵니다.
이제 배열 $a$를 유지할 필요가 없습니다. 최솟값을 찾는 자료구조 자체가 아직 처리하지 않은 정점들의 집합 역할을 하기 때문입니다.
vector<int> dijkstra(int s) {
    vector<int> d(n, inf);
    d[root] = 0;
    set< pair<int, int> > q;
    q.insert({0, s});
    while (!q.empty()) {
        int v = q.begin()->second;
        q.erase(q.begin());
        for (auto [u, w] : g[v]) {
            if (d[u] > d[v] + w) {
                q.erase({d[u], u});
                d[u] = d[v] + w;
                q.insert({d[u], u});
            }
        }
    }
    return d;
}
각 간선마다 $O(n)$개의 원소를 저장하는 이진 트리에 각각 $O(\log n)$ 시간이 걸리는 쿼리를 두 번 수행해야 하므로, 이러한 알고리즘의 점근적 복잡도는 $O(m \log n)$이 됩니다. 완전 그래프의 경우 이는 $O(n^2 \log n)$이 되므로, 앞의 알고리즘을 잊어서는 안 된다는 점에 유의하십시오.
#힙 사용
이진 트리 대신, 원소 추가와 최솟값 찾기를 정확히 지원하는 더 특화된 구조인 힙을 사용하는 것이 「더 올바릅니다」. 힙에서 임의의 원소를 삭제하는 것은 조금 더 복잡하므로, 그 대신 중복된 정점을 모두 단순히 무시하겠습니다.
vector<int> dijkstra(int s) {
    vector<int> d(n, inf);
    d[root] = 0;
    // объявим очередь с приоритетами для *минимума* (по умолчанию ищется максимум)
    using pair<int, int> Pair;
    priority_queue<Pair, vector<Pair>, greater<Pair>> q;
    q.push({0, s});
    while (!q.empty()) {
        auto [cur_d, v] = q.top();
        q.pop();
        if (cur_d > d[v])
            continue;
        for (auto [u, w] : g[v]) {
            if (d[u] > d[v] + w) {
                d[u] = d[v] + w;
                q.push({d[u], u});
            }
        }
    }
}
실제로는 priority_queue를 사용하는 방식이 조금 더 빠릅니다.
일반적인 이진 힙 외에 다른 힙을 사용할 수도 있습니다. 이론적인 관점에서 특히 흥미로운 것은 피보나치 힙입니다. 이 힙에서는 거의 모든 연산이 $O(1)$에 동작하지만, 원소 삭제는 $O(\log n)$에 동작합니다. 이를 통해 최솟값 추출 시간을 $O(\log n)$으로 늘리는 대신 완화를 $O(1)$로 가볍게 만들 수 있으며, 그 결과 $O(m \log n)$ 대신 $O(n \log n + m)$의 점근적 복잡도를 얻습니다.
#경로 복원
최단 경로의 길이뿐만 아니라 경로 자체도 구해야 하는 경우가 많습니다.
이를 위해 배열 $p$를 만들 수 있으며, 이 배열의 칸 $p_v$에는 정점 $v$의 부모, 즉 간선 $(p_v, v)$를 따라 마지막 완화가 일어난 정점이 저장됩니다.
이 배열은 배열 $d$와 함께 갱신할 수 있습니다. 예를 들어, 마지막 구현에서는 다음과 같습니다.
if (d[u] > d[v] + w) {
    d[u] = d[v] + w;
    p[u] = v; // <-- кратчайший путь в u идет через ребро (v, u)
    q.push({d[u], u});
}
경로를 복원하려면 정점 $v$의 조상들을 따라가기만 하면 됩니다:
void print_path(int v) {
    while (v != s) {
        cout << v << endl;
        v = p[v];
    }
    cout << s << endl;
}
이 코드는 경로를 역순으로 출력한다는 점에 유의하십시오.