너비 우선 탐색(영어: breadth-first search)은 그래프의 기본 알고리즘 중 하나로, 주어진 정점에서 출발하는 모든 최단 경로를 찾고 그 밖의 여러 문제를 해결할 수 있게 해 줍니다.
너비 우선 탐색은 순회라고도 부릅니다. 깊이 우선 탐색을 비롯한 다른 모든 순회와 마찬가지로 그래프의 모든 정점을 한 번씩 방문하지만, 방문 순서가 다릅니다. 너비 우선 탐색은 시작 정점까지의 거리가 증가하는 순서로 방문합니다.
#알고리즘 설명
알고리즘의 입력으로는 가중치가 없는 그래프와 시작 정점의 번호 $s$가 주어집니다. 그래프는 방향 그래프일 수도 있고 무방향 그래프일 수도 있으며, 알고리즘에는 이것이 중요하지 않습니다.
알고리즘의 기본 아이디어는 그래프에 “불을 붙이는” 과정으로 이해할 수 있습니다. 0번째 단계에서 정점 $s$에 불을 붙이고, 이후 각 단계마다 이미 불타고 있는 각 정점의 불이 그 정점의 모든 이웃으로 옮겨붙어 결국 그래프 전체에 불이 붙게 됩니다.
이 과정을 모델링하면, 알고리즘의 매 반복마다 「불의 고리」가 너비 방향으로 1만큼씩 확장됩니다. 정점 $v$에 불이 붙기 시작하는 단계의 번호는 정점 $s$로부터 $v$까지의 최단 경로 길이와 정확히 같습니다.
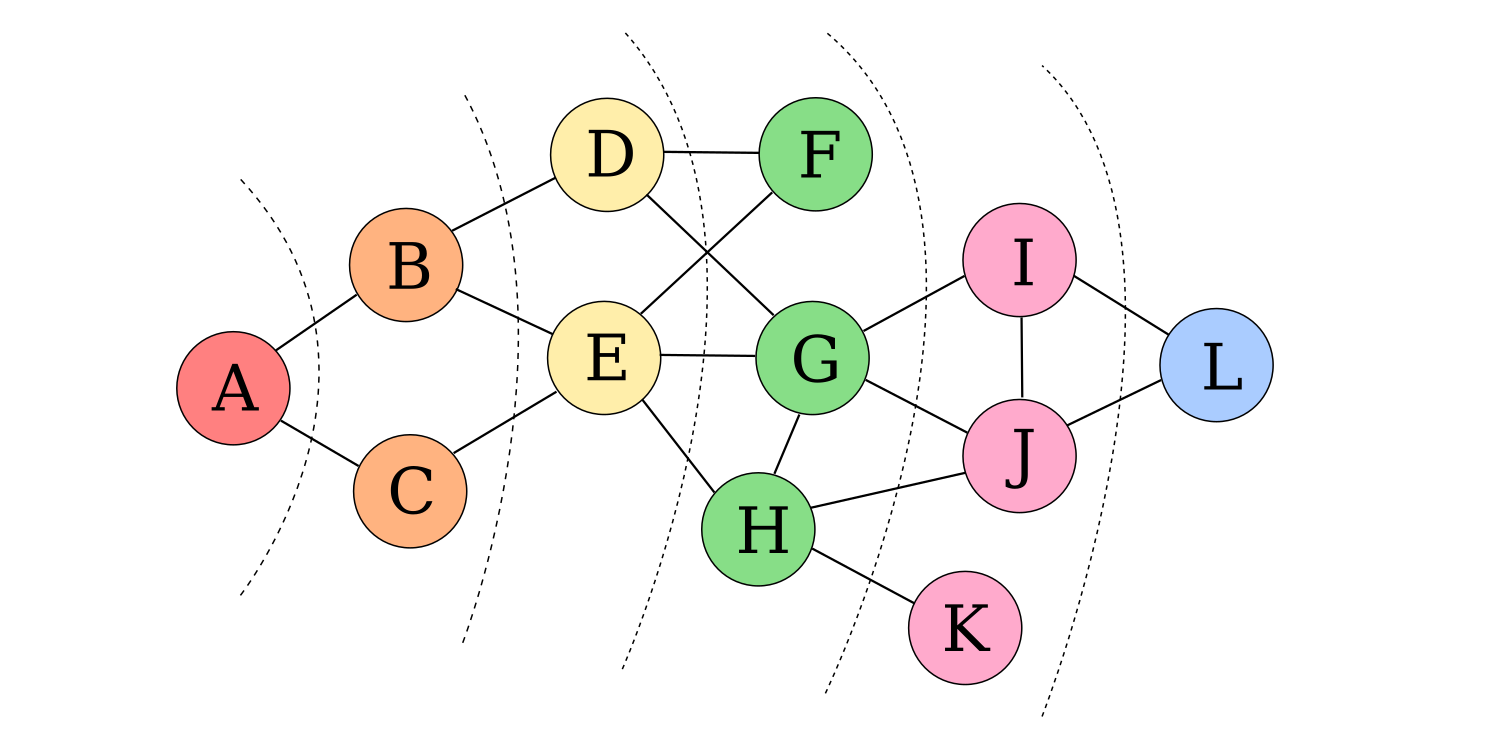
이는 다음과 같이 모델링할 수 있습니다. 불타는 정점들을 넣을 큐를 만들고, 각 정점에 대해 그 정점이 불타고 있는지 아닌지, 다시 말해 이미 방문했는지를 표시할 불리언 배열도 하나 만듭시다. 처음에는 큐에 정점 $s$만 들어 있으며, 이 정점은 곧바로 불타는 것으로 표시됩니다.
그런 다음 알고리즘은 다음과 같은 반복으로 이루어집니다. 큐가 비어 있지 않은 동안 큐의 앞에서 정점 $v$ 하나를 꺼내고, 이 정점에서 나가는 모든 간선을 살펴본 뒤, 인접한 정점 $u$ 중 아직 불타지 않는 것이 있으면 그 정점에 불을 붙이고 큐의 끝에 넣습니다.
결국 큐가 비게 되면 $s$에서 도달 가능한 모든 정점을 한 번씩 방문하게 되며, 각 정점에는 최단 경로로 도달하게 됩니다. 최단 경로의 길이는 이를 위한 별도의 배열 $d$를 두고, 큐에 추가할 때 $d_u = d_v + 1$ 규칙에 따라 갱신하면 계산할 수 있습니다. 또한 각 정점마다 그 정점에 어느 정점에서 왔는지를 저장하는 “부모” 배열을 두면, 경로 자체를 복원하기 위한 추가 정보를 간결하게 저장할 수 있습니다.
#구현
어차피 거리 배열을 유지하고 있다면 불타고 있는 정점을 표시하는 별도의 불리언 배열을 만들지 않아도 됩니다. 대신 모든 정점의 초기 거리를 어떤 특수한 값(예를 들어 -1)으로 설정해 두면, 그 값이 해당 정점을 아직 방문하지 않았다는 표시가 됩니다.
vector<int> g[maxn];

void bfs(int s) {
    queue<int> q;
    q.push(s);

    vector<int> d(n, -1), p(n);
    d[s] = 0;

    while (!q.empty()) {
        int v = q.front();
        q.pop();
        for (int u : g[v]) {
            if (d[u] == -1) {
                q.push(u);
                d[u] = d[v] + 1;
                p[u] = v;
            }
        }
    }
}
이제 어떤 정점 $v$까지의 최단 경로를 복원하려면 배열 p를 이용하면 됩니다:
while (v != s) {
    cout << v << endl;
    v = p[v];
}
경로가 역순으로 출력된다는 점에 유의하십시오.
#암시적 그래프에서
너비 우선 탐색은 암시적으로 주어진 그래프에서 최단 경로를 찾는 데 자주 사용됩니다.
구체적인 예로, 좌표가 $(x, y)$인 칸이 비어 있는지를 표시한 $n \times n$ 크기의 불리언 행렬이 있고, 한 번에 수직 또는 수평으로 인접한 빈 칸으로 이동할 수 있다는 조건에서 $(x_s, y_t)$에서 $(x_y, y_t)$까지의 최단 경로를 찾아야 한다고 합시다.
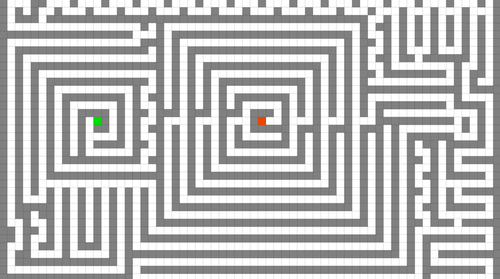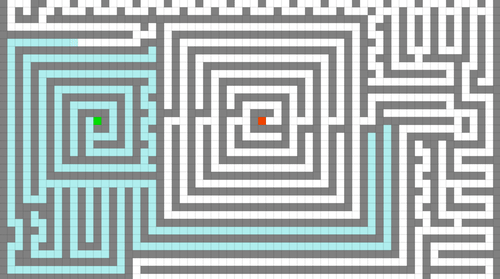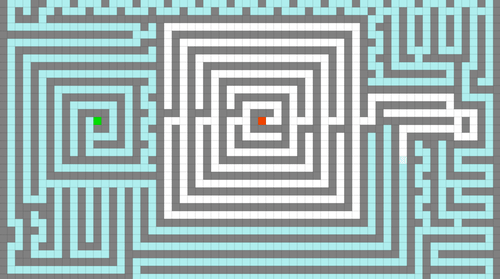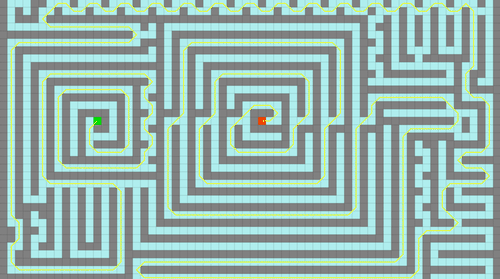
그래프를 명시적인 형식으로 변환할 수 있습니다. 모든 칸에 어떤 방식으로든 번호를 매기고(예를 들어 $x \cdot n + y$ 공식으로), 각 칸에 대해 모든 이웃을 살펴보면서 해당 칸이 비어 있으면 $(x \pm 1, y \pm 1)$로 향하는 간선을 추가하면 됩니다.
이러한 방식은 최적인 선형 시간에 동작하지만, 구현 측면에서는 입력 데이터가 아니라 깊이 우선 탐색 알고리즘 자체를 수정하는 편이 더 간단합니다:
bool a[N][N]; // свободна ли клетка (x, y)
int d[N][N];  // кратчайшее расстояние до (x, y)

// чтобы немного упростить код
struct cell {
    int x, y;
};

void bfs(cell s, cell t) {
    queue<cell> q;
    q.push(s);

    memset(d, -1, sizeof d);
    d[s.x][x.y] = 0;

    while (!q.empty()) {
        auto [x, y] = q.front();
        q.pop();
        // просматриваем всех соседей
        for (auto [dx, dy] : {{-1, 0}, {+1, 0}, {0, -1}, {0, +1}}) {
            // считаем координаты соседа
            int _x = x + dx, _y = y + dy;
            // и проверяем, что он свободен и не был посещен ранее
            if (a[_x][_y] && d[_x][_y] == -1) {
                d[_x][_y] = d[x][y] + 1;
                q.push_back({_x, _y});
            }
        }
    }
}
bfs를 실행하기 전에 경계를 벗어나는 일이 발생하지 않도록 해야 합니다. 가능한 이웃을 살펴볼 때 _x < 0 || x >= n 등의 검사를 추가하는 대신, 다음과 같은 요령을 쓰면 편리합니다: 처음부터 행렬 a를 필요한 것보다 각 차원이 2만큼 더 크게 만들고, 데이터를 읽는 단계에서 0이 아니라 1부터 시작하는 인덱스로 채웁니다. 그러면 행렬의 경계는 항상 0으로 채워져 있게 되고(즉, 지나갈 수 없는 칸으로 표시되고), 알고리즘은 절대 그곳에 들어가지 않습니다.
#응용과 일반화
가중치 없는 그래프에서 거리를 구하는 것 외에도, 너비 우선 탐색은 깊이 우선 탐색이 쓰이는 많은 문제에 사용할 수 있습니다. 예를 들어 연결 요소 찾기나 이분 그래프 판별에 사용할 수 있습니다.
다중 시작점 BFS. 처음에 큐에 정점을 하나가 아니라 여러 개 넣으면, 각 정점에서 그중 하나까지의 최단 거리를 구할 수 있습니다.
이는 화재, 홍수, 화산 폭발처럼 「파동」의 근원이 하나가 아닌 현상을 모델링해야 하는 문제에 유용합니다. 또한 이 방법을 사용하면 특정한 두 정점 사이의 최단 경로를 조금 더 빠르게 찾을 수 있습니다. 두 정점 각각에서 탐색을 병렬로 시작하고, 두 탐색이 만나는 순간 멈추면 됩니다.
게임. 시스템의 각 상태를 그래프의 정점으로, 한 상태에서 다른 상태로의 전이를 그래프의 간선으로 나타낼 수 있다면, BFS를 사용하여 어떤 문제나 게임의 해를 최소 이동 횟수로 찾을 수 있습니다.
(자명하지 않은) 예로는 루빅스 큐브를 최소 횟수의 움직임으로 맞추는 문제가 있습니다.
최단 사이클. 방향 가중치 없는 그래프에서 최단 사이클을 찾으려면 각 정점에서 너비 우선 탐색을 수행하면 됩니다. 탐색 도중 현재 정점에서 어떤 간선을 따라 이미 방문한 정점으로 가려고 하는 순간, 이는 해당 정점에 대한 최단 사이클을 찾았다는 뜻이므로 탐색을 멈춥니다. 이렇게 찾은 모든 사이클(탐색을 실행할 때마다 하나씩) 중에서 가장 짧은 것을 고릅니다.
이러한 알고리즘은 $O(n^2)$에 동작합니다. 최악의 경우는 하나의 큰 사이클로, 이때 각 정점마다 나머지 모든 정점을 순회하게 됩니다.
최단 경로 위의 간선. 주어진 정점 쌍 $a$와 $b$ 사이의 어떤 최단 경로 위에 놓인 모든 간선을 선형 시간에 찾을 수 있습니다. 이를 위해서는 $a$에서 한 번, $b$에서 한 번, 총 두 번의 너비 우선 탐색을 실행해야 합니다.
이 탐색들의 결과로 얻은 최단 거리 배열을 $d_a$와 $d_b$로 나타냅시다. 그러면 각 간선 $(u,v)$는 다음 기준으로 확인할 수 있습니다.
$$ d_a[u] + d_b[v] + 1 = d_a[b] $$또는, $a$에서 탐색을 한 번만 실행하고, 탐색이 $b$에 도달하면 $a$에 더 가까운 정점(즉, $d[u] = d[v] - 1$인 정점)으로 이어지는 모든 역방향 간선을 재귀적으로 따라가며 이들을 따로 표시할 수도 있습니다.
마찬가지로 어떤 최단 경로 위에 놓인 모든 정점을 찾을 수 있습니다.
0-1 BFS. 일부 간선의 가중치가 0일 수 있는 경우에도 최단 경로를 찾는 것은 그리 어렵지 않습니다.
핵심 관찰은 다음과 같습니다. 정점 $a$에서 정점 $b$까지 0인 간선들로만 이루어진 경로로 갈 수 있다면, 정점 $s$에서 이 두 정점까지의 최단 거리는 같습니다.
그래프에 $0$-간선만 남기면 그래프는 여러 연결 요소로 나뉘며, 각 연결 요소 안에서는 답이 모두 같습니다. 이제 가중치가 1인 간선을 다시 추가하고, 이 간선들이 정점이 아니라 연결 요소를 서로 잇는다고 보면 문제는 일반적인 BFS로 환원됩니다.
결국 탐색을 실행하면서, 방문하지 않은 정점으로 향하는 0-간선이 있는 정점 $v$를 처리할 때 곧바로 그 간선들을 따라가 0-컴포넌트의 모든 정점을 추가하고, 그 정점들에 $v$와 같은 거리를 부여할 수 있습니다.
BFS 안에서 BFS를 실행하여 이를 직접 처리할 수도 있지만, 정점을 방문할 때 0-간선으로 연결된 방문하지 않은 이웃을 모두 큐의 머리에 추가하기만 하면, 이미 큐에 들어 있는 정점보다 먼저 처리할 수 있다는 점에 주목할 수 있습니다. 큐를 덱으로 바꾸면 이를 쉽게 구현할 수 있습니다:
vector<int> d(n, -1);
d[s] = 0;

deque<int> q;
q.push_back(s);

while (!q.empty()) {
    int v = q.front();
    q.pop_front();
    for (auto [u, w] : g[v]) {
        if (d[u] == -1) {
            d[u] = d[v] + w;
            if (w == 0)
                q.push_front(u);
            else
                q.push_back(u);
        }
    }
}
또한 덱 대신 큐를 두 개 만들 수도 있습니다. 하나는 가중치가 0인 간선용, 다른 하나는 가중치가 1인 간선용으로 두고, while 루프 안에서 먼저 첫 번째 큐를 살펴보고, 그것이 비었을 때에만 두 번째 큐를 살펴보는 것입니다. 이 접근법은 이제 일반화할 수 있습니다.
1-k BFS. 이제 간선의 가중치는 $1$부터 어떤 작은 $k$까지의 값을 가지며, 여전히 정점 $s$로부터의 최단 거리를 구해야 하지만 이번에는 가중치의 합을 기준으로 합니다.
관찰: 그래프에서 최단 거리의 최댓값은 $(n - 1) \cdot k$입니다.
각 거리 $d$마다 큐 $q_d$를 하나씩 만듭시다. 이 큐에는 $s$로부터 거리가 $d$인 정점들이 저장되며, 이에 더해 $s$로부터 길이 $d$인 경로를 이미 찾았지만 더 짧은 경로가 존재할 수도 있는 정점들이 일부 들어 있을 수 있습니다. 큐는 $O((n - 1) \cdot k)$개가 필요합니다.
처음에 정점 $s$를 $q_0$에 넣고, 그다음부터는 비어 있지 않은 가장 작은 리스트에서 정점을 꺼내어 아직 방문하지 않은 모든 이웃을 번호가 $d_v + w$인 큐에 넣고 $d_u$를 완화합니다. 이때 그 정점까지의 최단 거리가 실제로는 더 작을 수도 있다는 점을 잊지 않아야 합니다.
int d[maxn];
d[s] = 0;

queue<int> q[maxd];
q[0].push_back(s);

for (int dist = 0; dist < maxd; dist++) {
    while (!q[dist].empty()) {
        int v = q[dist].front();
        q[dist].pop();
        // если расстояние меньше и мы уже рассмотрели эту вершину,
        // но она всё ещё лежит в более верхней очереди
        if (d[v] > dist)
            continue;
        for (auto [u, w] : g[v]) {
            if (d[u] < d[v] + w) {
                d[u] = d[v] + w;
                q[d[u]].push(u);
            }
        }
    }
}
각 정점은 최대 $k$번까지 완화되어 다른 큐에 추가될 수 있고, 정점에서 나가는 간선은 그 정점을 맨 처음 처리할 때에만 살펴보므로, 이 알고리즘의 시간 복잡도는 $O(k n + m)$입니다.
사실 이렇게 많은 리스트가 필요하지는 않습니다. 각 간선의 가중치가 $k$ 이하라면, 어느 시점에서든 비어 있지 않은 큐는 최대 $k$개입니다. 리스트를 $k$개만 만들고, $(d_v + w)$번째 리스트에 추가하는 대신 $(d_v+w) \bmod k$번째 리스트를 사용할 수 있습니다.
이 알고리즘은 각 간선의 가중치뿐만 아니라 경로 길이 전체에 제한이 있는 경우에도 동작한다는 점에 주목하십시오. 간선의 가중치가 임의의 음이 아닌 값일 수 있는 더 일반적인 경우에는 다익스트라 알고리즘이 있으며, 이는 다음 글에서 살펴보겠습니다.