서로소 집합(영어: disjoint set union)은 서로소인 집합들을 합치고, 이 집합들에 대한 여러 쿼리, 예를 들어 “원소 $a$와 $b$가 같은 집합에 속해 있는가”, “주어진 집합의 크기는 얼마인가"에 답할 수 있게 해 주는 자료구조입니다.
더 형식적으로 말하면, 처음에는 $n$개의 원소가 있고 각 원소는 별도의 (자기 자신만의) 집합에 속해 있습니다. 이 자료구조는 두 가지 기본 연산을 지원합니다:
- 임의의 두 집합을 합칩니다.
- 지정한 원소가 현재 어느 집합에 속해 있는지 조회합니다.
두 연산 모두 평균적으로 거의 $O(1)$에 수행됩니다(완전히 그렇지는 않습니다).
DSU는 그래프 알고리즘에서 컴포넌트의 연결성 정보를 저장하는 데 자주 사용됩니다. 예를 들어 크루스칼 알고리즘에서 사용됩니다.
#자료 구조의 구성
원소들의 집합은 트리 형태로 저장하겠습니다. 하나의 트리가 하나의 집합에 대응합니다. 트리의 루트는 집합의 대표(리더)입니다. 트리의 루트에 대해서는 그 조상이 자기 자신이라고 간주하겠습니다.
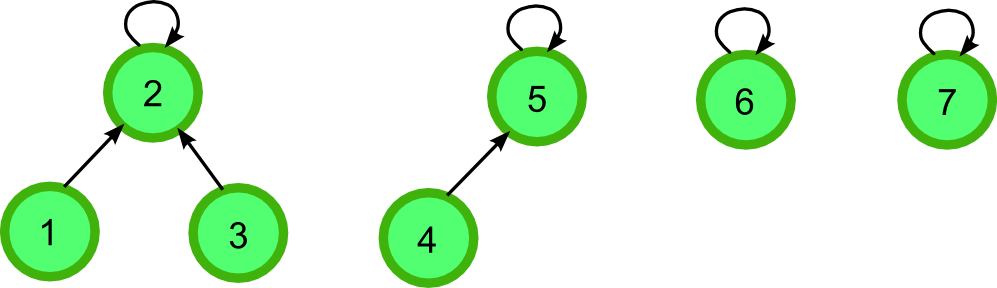
각 원소마다 트리에서 그 원소의 부모 번호를 저장하는 배열 p를 만듭시다:
int p[maxn];

for (int i = 0; i < n; i++)
    p[i] = i;
“원소 $v$가 어느 집합에 속하는가"라는 쿼리를 처리하려면 링크를 따라 루트까지 올라가야 합니다:
int leader(int v) {
    if (p[v] == v)
        return v;
    else
        return leader(p[v]);
}
두 집합을 합치려면 한 집합의 루트를 다른 집합의 루트에 매달면 됩니다:
void unite(int a, int b) {
    a = leader(a), b = leader(b);
    p[a] = b;
}
안타깝게도 최악의 경우 이러한 구현은 $O(n)$에 동작합니다. 새 정점에 $n$번 매달아 «대나무»를 만들 수 있기 때문입니다. 이제 이 문제를 고쳐 보겠습니다.
#최적화
먼저 최적화 아이디어를 소개한 다음, 그것이 얼마나 잘 작동하는지 분석하겠습니다.
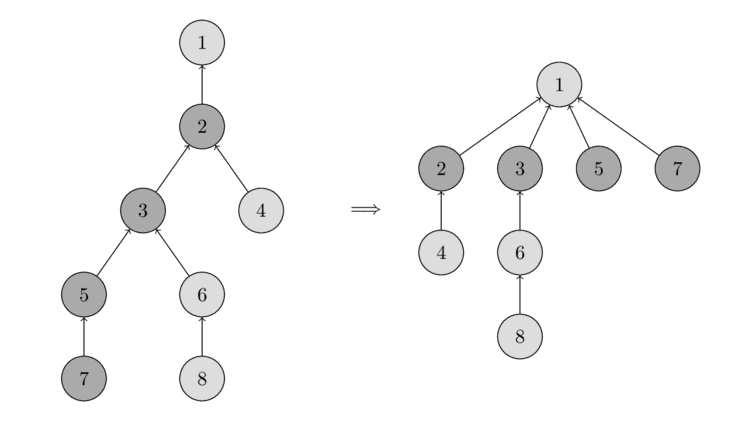
경로 압축 휴리스틱. leader 함수의 동작을 최적화합시다. 답을 반환하기 전에 그 답을 현재 정점의 p에 기록합시다. 즉, 현재 정점을 가장 높은 정점 아래에 다시 매다는 것입니다.
int leader(int v) {
    return (p[v] == v) ? v : p[v] = leader(p[v]);
}
다음 두 휴리스틱은 취지가 비슷하며, 다시 매달 때 최적의 루트를 골라 트리의 높이를 최적화하려고 합니다.
랭크 휴리스틱. 각 정점마다 그 정점의 랭크, 즉 서브트리의 높이를 저장합시다. 트리를 합칠 때는 랭크가 더 큰 정점을 새 트리의 루트로 삼고 랭크를 다시 계산합니다(리더의 랭크가 다른 정점의 랭크와 같았다면 리더의 랭크는 1만큼 증가해야 합니다). 이 휴리스틱은 트리의 높이를 직접 최적화합니다.
void unite(int a, int b) {
    a = leader(a), b = leader(b);
    if (h[a] > h[b])
        swap(a, b);
    h[b] = max(h[b], h[a] + 1);
    p[a] = b;
}
가중치 휴리스틱. 랭크 대신 각 정점마다 서브트리의 크기를 저장하고, 합칠 때는 더 「무거운」 쪽에 매답니다.
void unite(int a, int b) {
    a = leader(a), b = leader(b);
    if (s[a] > s[b])
        swap(a, b);
    s[b] += s[a];
    p[a] = b;
}
대표 정점을 선택하는 휴리스틱들은 서로 배타적이지만, 경로 압축과는 함께 사용할 수 있습니다.
#구현
랭크 휴리스틱(크기 기준)과 경로 압축 휴리스틱을 사용하는 최종 구현은 다음과 같습니다:
int p[maxn], s[maxn];

int leader(int v) {
    return (p[v] == v) ? v : p[v] = leader(p[v]);
}

void unite(int a, int b) {
    a = leader(a), b = leader(b);
    if (s[a] > s[b])
        swap(a, b);
    s[b] += s[a];
    p[a] = b;
}

void init(n) {
    for (int i = 0; i < n; i++)
        p[i] = i, s[i] = 1;
}
저자는 문제에서 컴포넌트의 크기 자체가 필요한 경우가 많기 때문에 굳이 가중치 휴리스틱을 선호합니다.
#점근적 복잡도
경로 압축 휴리스틱은 점근적 복잡도를 평균 $O(\log n)$까지 개선합니다. 여기서는 바로 분할 상환 평가를 사용합니다. 최악의 경우에는 대나무 전체를 $O(n)$에 압축해야 한다는 것은 자명하기 때문입니다.
귀납법으로 가중치 휴리스틱과 랭크 휴리스틱이 트리의 높이를 $O(\log n)$으로 제한하며, 따라서 루트를 찾는 연산의 점근적 복잡도 역시 그만큼으로 제한된다는 것을 어렵지 않게 보일 수 있습니다.
경로 압축 휴리스틱을 가중치 휴리스틱 또는 랭크 휴리스틱과 함께 사용하면 시간 복잡도는 $O(a(n))$이 되며, 여기서 $a(n)$은 역 아커만 함수(매우 느리게 증가하는 함수로, 현실적인 모든 수에 대해 4를 넘지 않습니다)입니다.
증명을 공부하거나 아커만 함수에 관한 위키백과 문서를 읽는 데조차 시간을 들이는 것을 저자는 권하지 않습니다.