희소 테이블(영어: sparse table)은 $O(n \log n)$의 시간과 메모리를 들이는 전처리로 구간 최솟값 쿼리에 $O(1)$에 답할 수 있게 하는 자료 구조입니다.
정의. 희소 테이블은 다음과 같은 크기 $\log n \times n$의 2차원 배열입니다:
$$ t[k][i] = \min \{ a_i, a_{i+1}, \ldots, a_{i+2^k-1} \} $$쉽게 말하면, 길이가 $2^k$인 모든 구간에서 최솟값을 계산합니다.
이러한 배열은 $i$ 또는 $k$에 대해 반복하면서 그 크기만큼의 시간에 계산할 수 있습니다:
$$ t[k][i] = \min(t[k-1][i], t[k-1][i+2^{k-1}]) $$이러한 배열이 있으면, 임의의 구간에 대해 그 구간의 최솟값을 빠르게 구할 수 있습니다. 임의의 구간에 대해, 서로 겹치면서도, 무엇보다 그 구간 전체를, 그리고 오직 그 구간만을 덮는 길이가 2의 거듭제곱인 두 구간이 존재한다는 점에 주목하십시오. 따라서 이 두 구간에 해당하는 값들 중 최솟값을 취하기만 하면 됩니다.
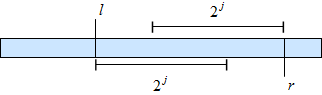
마지막으로 짚을 점이 있습니다. 쿼리당 상수 시간이 실제로 상수가 되려면 로그 자체도 상수 시간에 계산할 수 있어야 합니다. 이를 위해 GCC에서 제공하는 __lg 함수를 사용할 수 있습니다. 이 함수는 내부적으로 clz(“count leading zeros”) 명령어를 사용합니다. 이 명령어는 대부분의 최신 프로세서에 있으며, 이진 표현에서 첫 번째 1이 나오기 전까지의 0의 개수를 반환합니다. 이 값으로부터 프로세서 클럭 몇 사이클 만에 필요한 내림 로그 값을 얻을 수 있습니다.
int a[maxn], mn[logn][maxn];

int rmq(int l, int r) { // полуинтервал [l; r)
    int t = __lg(r - l);
    return min(mn[t][l], mn[t][r - (1 << t)]);
}

// Это считается где-то в первых строчках main:

memcpy(mn[0], a, sizeof a);

for (int l = 0; l < logn - 1; l++)
    for (int i = 0; i + (2 << l) <= n; i++)
        mn[l+1][i] = min(mn[l][i], mn[l][i + (1 << l)]);
큰 테이블에서는 반복 순서와 메모리상의 데이터 배치가 구축 속도에 큰 영향을 미치는데, 이는 캐시의 동작 방식과 관련이 있습니다. 하지만 대부분의 경우 구축 시간은 그다지 중요하지 않습니다.
연습 문제. 나머지 4가지 반복 순서와 레이아웃 방식에는 각각 어떤 단점이 있는지 생각해 보십시오.
#응용
희소 테이블은 정적 자료구조입니다. 즉, 적은 비용으로 갱신할 수 없습니다(다만 진행 중에 덧붙여 구성하는 것은 가능합니다 — ROI-2017의 「Антиматерия」 문제를 참고하십시오).
희소 테이블은 RMQ로 환원할 수 있으므로 최소 공통 조상 문제를 해결하는 데 자주 사용됩니다.
#2차원 정적 RMQ
이 구조 역시 더 높은 차원으로 일반화할 수 있습니다. 부분 정사각형에 대해 RMQ를 계산하고 싶다고 합시다. 그러면 배열 t[k][i] 대신 배열 t[k][i][j]를 사용하게 되며, 여기에는 구간에 대한 최솟값 대신 같은 2의 거듭제곱 크기의 정사각형에 대한 최솟값이 저장됩니다. 그러면 임의의 정사각형에서 최솟값을 구하는 것은 길이가 $2^k$인 정사각형 네 개의 최솟값으로 나뉩니다.
일반적인 경우에는 $d$차원 배열의 직사각형에서 최솟값을 구하라는 요청을 받습니다. 이 경우 앞의 경우와 비슷한 전처리를 수행하면 되는데, 다만 이제는 전처리에 $O(n \log^d n)$의 메모리와 시간이 듭니다. 변의 길이가 2의 거듭제곱인 모든 초직사각형에서의 최솟값을 저장해야 하기 때문입니다.
#연산에 대한 제약
희소 테이블은 최솟값이나 최댓값뿐만 아니라 다른 연산에도 사용할 수 있습니다. 연산에 필요한 조건은 결합법칙($a ∘ (b ∘ c) = (a ∘ b) ∘ c$), 교환법칙($a ∘ b = b ∘ a$), 멱등성($a ∘ a = a$)뿐입니다. 예를 들어, $\gcd$를 구하는 데에도 사용할 수 있습니다.
연산이 멱등적이지 않다면 그 결과를 구하기 위해 다음과 같이 할 수 있습니다. 쿼리의 왼쪽 경계에서 시작하는 가장 긴 구간을 골라 답에 더하고, 포인터를 그 구간의 오른쪽 끝으로 옮긴 다음, 쿼리 전체를 처리할 때까지 이 과정을 계속합니다.
int sum(int l, int r) { // [l, r)
    int res = 0;
    for (int d = logn - 1; d >= 0; d--) {
        if (l + (1 << d) < r) {
            res += t[l][d];
            l += (1 << d);
        }
    }
    return res;
}
이 방법은 예를 들어 세그먼트 트리보다 빠르게 동작하지만, 점근적으로는 마찬가지로 $O(\log n)$이 걸리며 추가 메모리까지 필요합니다. 하지만 이를 더 빠르게 만드는 방법이 있습니다.
#서로소 희소 테이블(Disjoint Sparse Table)
우리는 $f$가 멱등성 조건을 만족하지 않더라도 구간에서 함수 $f$를 계산할 수 있는 어떤 자료구조를 원합니다. 표준 희소 테이블은 여기에 적합하지 않습니다. 희소 테이블에서는 서로 겹치지 않는 구간 $O(1)$개를 찾을 수 없기 때문입니다.
다음과 같이 합시다. 배열 위에 세그먼트 트리를 머릿속으로 구성하고, (이번에는 머릿속이 아니라 실제로) 그 트리의 각 구간 $[l, r)$마다 중앙 원소, 즉 인덱스가 $m = \lfloor \frac{l + r}{2} \rfloor$인 원소에서 나머지 모든 원소 $k \in [l, r)$까지의 모든 구간에 대해 $f$를 계산합니다. 배열의 각 원소마다 중앙 원소가 $O(\log n)$개 있으므로, 이를 위해 총 $O(n \log n)$의 시간과 메모리가 똑같이 필요합니다.
명제. 모든 쿼리 $[l, r)$는 서로 겹치지 않는 미리 계산된 구간 $O(1)$개로 분할됩니다.
증명. 질의에 속하는 중심 원소 중 가장 높은 원소 $m$을 택합시다. 그 원소의 구간은 질의를 완전히 덮습니다. 그렇지 않다면 가장 높은 원소는 $m$이 아니라 그 구간의 경계 중 하나였을 것입니다. 쿼리 구간 $[l, r)$가 완전히 덮이고 $m$이 그 안에 있으므로, $[l, r)$는 미리 계산된 $[l, m)$과 $[m, r)$로 분할할 수 있습니다.
문제는 바로 이렇게 풀겠습니다. 필요한 중심 원소를 찾고, 그 원소에서 두 개의 쿼리를 수행합니다.
#구현
어려운 부분, 즉 이 중앙 원소를 상수 시간에 찾는 일은 길이가 2의 거듭제곱인 배열과 그에 따른 완전 세그먼트 트리만 다룬다면 조금 더 쉬워집니다. 길이가 맞지 않는 배열은 연산 자체에 따라 정해지는 특별한 항등원(예를 들어 덧셈에는 $0$, 곱셈에는 $1$)으로 채워 가장 가까운 2의 거듭제곱 길이로 맞춥니다.
전체 구조(구간별로 미리 계산해 둔 값)는 배열 t[logn][maxn]에 저장하겠습니다. 이 배열의 첫 번째 인자는 세그먼트 트리에서의 레벨(크기가 $2^d$인 구간에 대한 수 $d$)이고, 두 번째 인자는 해당 구간의 경계(수 $k$)입니다. 이 정보만으로 구간을 유일하게 복원할 수 있습니다.
질의에 답하려면 필요한 중앙 원소의 레벨만 찾으면 충분합니다. 이를 효율적으로 하는 방법을 익히려면 세그먼트 트리의 본질에 대해 조금 생각해 볼 필요가 있습니다.
$k$번째 레벨의 모든 정점은 어떤 구간 $[l, l + 2^k)$에 대응하며, 이때 $l$은 $2^k$로 나누어떨어진다는 점에 주목합시다. 이 구간에 속한 모든 인덱스의 이진 표현은 어떤 공통 접두사를 가지며, 마지막 $k$자리는 서로 다릅니다.
필요한 중앙 원소의 레벨을 찾아야 합니다. 이는 원소 $l$과 $r$에 대한 최소 공통 구간의 레벨과 같습니다. 앞의 사실을 이용하면, 구하려는 레벨은 수 $l$과 $r$에서 서로 다른 가장 상위 비트의 위치와 같다는 것을 얻습니다. 로그를 미리 계산해 두면, 이는 $h_{[l,r)]} = \lfloor \log_2 (l \oplus r) \rfloor$ 식으로 상수 시간에 구할 수 있습니다.
예를 들어, 합성수 모듈러에 대한 곱셈을 위한 DST를 구축해 봅시다:
const int maxn = (1 << logn);
int a[maxn], lg[maxn], t[logn][maxn];

const int neutral = 1;
int f(int a, int b) {
    return (a * b) % 1000;
}

void build(int l, int r, int level = logn - 1) {
    int m = (l + r) / 2;

    int cur = neutral;
    for (int i = m + 1; i < r; i++) {
        cur = f(cur, a[i]);
        t[level][i] = cur;
    }

    cur = neutral;
    for (int i = m; i >= l; i--) {
        cur = f(cur, a[i]);
        t[level][i] = cur;
    }

    if (r - l > 1) {
        build(l, mid, level+1);
        build(mid, r, level+1);
    }
}

int rmq(int l, int r) { // [l, r)
    int level = lg[l ^ r];
    int res = t[level][l];
    // и, если правый отрезок не пустой:
    if (r & ((1 << lg[l ^ r]) - 1)))
        res = f(res, t[level][r]);
    return res;
}
참고: 여기에는 버그가 있을 가능성이 매우 높습니다.