펜윅 트리 또는 이진 인덱스 트리(영어 binary indexed tree)는 많은 문제에서 세그먼트 트리를 대체하는 자료 구조로, 세그먼트 트리보다 3~4배 빠르게 동작하고, 가능한 최소한의 메모리(같은 길이의 배열과 동일한 양)만 차지하며, 작성하기가 훨씬 빠르고 더 높은 차원으로 일반화하기도 쉽습니다.
#정의
길이가 $n$인 배열 $a$가 주어졌다고 합시다. 같은 길이의 배열 $t$를 다음과 같이 정의하고, 이를 펜윅 트리라고 부르겠습니다:
$$ t_i = \sum_{k=F(i)}^i a_k $$여기서 $F$는 $F(i) \leq i$를 만족하는 어떤 함수입니다. 구체적인 정의는 나중에 하겠습니다.
합 쿼리. 구간의 합이 필요할 때, 이 쿼리를 두 개의 접두사 합으로 환원하겠습니다:
$$ sum(l, r) = sum(r) - sum(l-1) $$ 이 두 쿼리는 모두 다음 공식으로 계산합니다: $$ sum(k) = t_k + sum(F(k)-1) $$업데이트 쿼리. 원래 배열의 $k$번째 셀을 변경할 때, 이 셀이 반영된 모든 $t_i$를 업데이트합니다.
합을 계산할 때의 「하강」 횟수와 갱신할 때 관심 대상이 되는 $t_i$의 개수가 모두 $O(\log n)$이 되도록 $F$를 선택할 수 있습니다. 널리 쓰이는 함수는 두 가지입니다.
- $F_1(x) =$
x & (x + 1) - $F_2(x) =$
x - (x & -x) + 1
첫 번째 방식은 Викиконспекты와 e-maxx에 설명되어 있어서 더 널리 알려져 있습니다. 두 번째 방식은 뒤에서 보겠지만 외우기 쉽고 코드로 구현하기도 더 간단하며, 더 유연하기도 합니다. 예를 들어, 이 방식에서는 누적 합에 대한 이진 탐색을 할 수 있습니다. 우리는 이 방식을 사용하겠습니다.
참고. 아마 이 자료구조를 구현할 줄 아는 사람 중 이것이 어떻게 동작하는지 완전히 이해하는 사람은 4분의 1도 되지 않을 것입니다. 분석이 실제로 꽤 복잡하므로 마지막에 제시하겠습니다. 지금은 세부 사항은 접어 두고, 임의의 접두사가 $[F(i), i]$ 형태의 구간 $O(\log n)$개로 나뉘며 임의의 원소가 이러한 구간 중 최대 $O(\log n)$개에 포함된다는 사실을 그대로 받아들이시기를 권합니다.
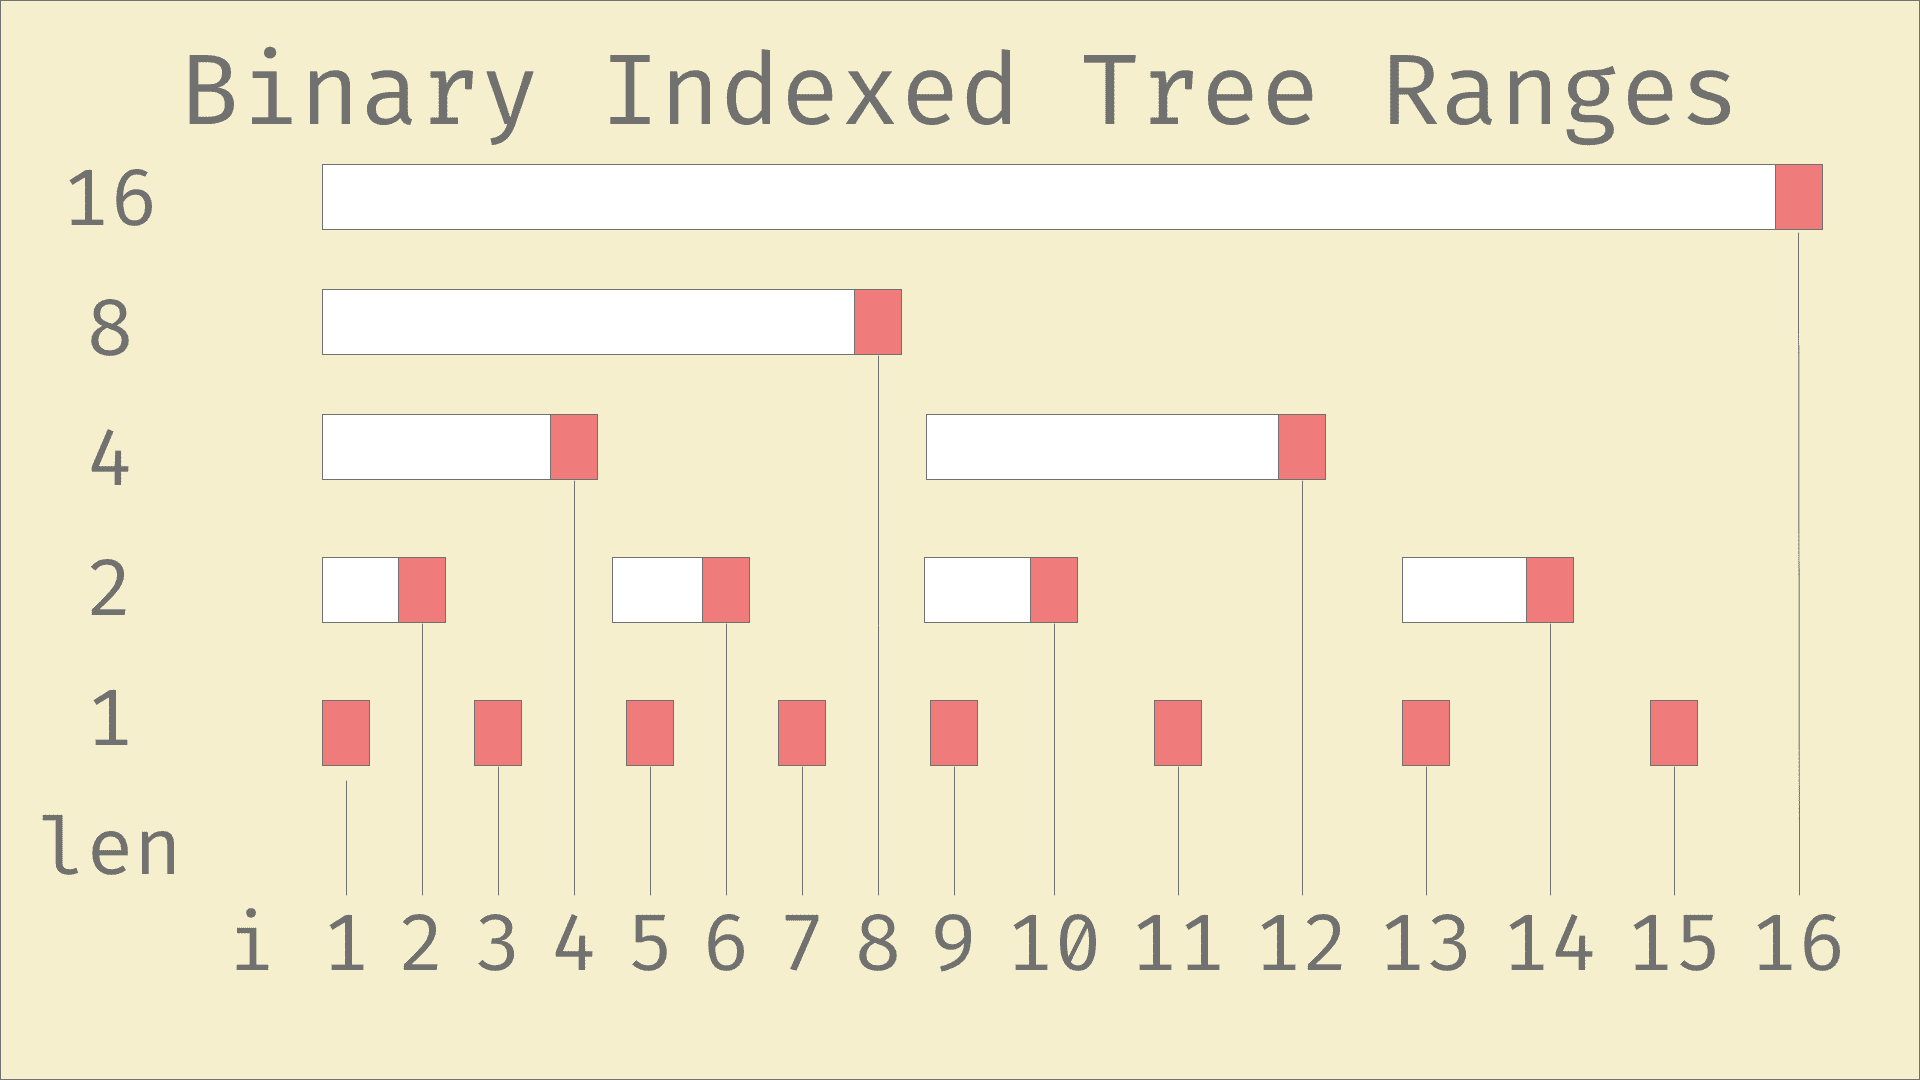
#구현
$F(0) = 1 > 0$이므로 $[0, F(0)]$는 올바른 구간이 아닙니다. 따라서 배열을 1-인덱스로 저장하고 $t_0$을 사용하지 않는 것이 더 편리합니다.
int t[maxn];

// возвращает сумму на префиксе
int sum (int r) {
    int res = 0;
    for (; r > 0; r -= r & -r)
        res += t[r];
    return res;
}

int sum (int l, int r) {
    return sum(r) - sum(l-1);
}

// обновляет нужные t
void add (int k, int x) {
    for (; k <= n; k += k & -k)
        t[k] += x;
}
저자는 r -= r & -r과 k += k & -k 공식에 「전통적인」 버전에는 없는 아름다운 대칭성이 있다고 언급합니다.
#다차원의 경우
$k$차원 펜윅 트리는 $(k+1)$줄로 작성됩니다.
sum과 add에 이와 같은 줄을 하나씩만 추가하면 되며, 직사각형 위의 합을 계산할 때에는 누적 합에 대한 쿼리를 두 번이 아니라 네 번 사용하면 됩니다.
sum은 다음과 같이 다시 작성됩니다:
int sum (int r1, int r2) {
    int res = 0;
    for (int i = r1; i > 0; i -= i & -i)
        for (int j = r2; j > 0; j -= j & -j)
            res += t[i][j];
    return res;
}
$k$차원의 경우, 포함-배제 원리에 따라 합 쿼리 하나를 처리하려면 접두사 합 쿼리가 $2^k$개 필요합니다.
차원이 메모리가 허용하는 것보다 크다면 배열 t 대신 해시 테이블을 사용할 수 있습니다. 이렇게 하면 잠재적으로 $O(q \log^2 A)$의 메모리가 필요하지만($A$는 최대 좌표입니다), 그래도 이는 2차원 구조에 관한 비교적 간단한 문제를 푸는 가장 수월한 방법 중 하나입니다.
#이진 탐색
사실 누적 합에 대한 이진 탐색(정확히는 하강)을 $O(\log n)$에 수행할 수 있습니다.
// возвращает индекс, на котором сумма уже больше
int lower_bound (int s) {
    int k = 0;
    for (int l = logn; l >= 0; l--) {
        if (k + (1<<l) <= n && t[k + (1<<l)] < s) {
            k += (1<<l);
            s -= t[k];
        }
    }
    return k;
}
$F(x)$가 $x$의 마지막 비트를 제거한다는 것을 알고 있다면 원리는 명확합니다. 세그먼트 트리에서와 마찬가지로 이진 트리를 따라 내려가기만 하면 됩니다. $k$번째 사전순 조합 객체를 생성하는 것과 어딘가 비슷합니다. 가능할 때마다 항상 다음 기호를 증가시키려고 시도합니다.
참고로 「전통적인」 인덱싱에서는 이렇게 할 수 없습니다.
#연산에 대한 제약
펜윅 트리는 연산이 역연산을 가질 때, 그리고 누적 합 트릭이 통할 때 사용할 수 있습니다. 보통 합, xor, 모듈러 곱셈(이 모듈러로 나누어떨어지는 값이 없다고 보장되는 경우)과 같은 단순한 연산이 이에 해당합니다. 최솟값과 gcd, 지연 연산과 영속성은 일반적으로 붙일 수 없으며, 이 경우에는 세그먼트 트리를 작성해야 합니다.
#왜 이것이 작동하는가
이제 우리는 $F(x)$ = x - (x & -x) + 1인 방식을 선택했습니다. x & -x가 무엇을 의미하는지 알아봅시다.
보조정리. x & -x는 x의 이진 표기에서 마지막 1인 비트를 반환합니다.
증명을 위해서는 컴퓨터에서 정수가 어떻게 저장되는지 알아야 합니다. 프로세서가 산술 연산을 할 때 수의 부호를 확인하느라 불필요한 클럭 사이클을 낭비하지 않도록, 정수는 말하자면 $2^k$를 법으로 하여 저장되며, 첫 번째 비트가 부호를 나타냅니다(양수는 0, 음수는 1). 따라서 음수가 어떤 모습인지 알고 싶다면 그 수를 0에서 빼야 합니다: $-x = 0-x = 2^k-x$.
-x는 비트 표기로 어떤 모습이 됩니까? 답은 머릿속으로 세 개의 블록으로 나누어 생각할 수 있습니다.
- 수 x의 끝에서부터 이어지는 처음 몇 개(0개일 수도 있습니다)의 0은 답에서도 그대로 0으로 남습니다.
- 그다음, 정확히 x의 가장 낮은 1 비트 위치에서 많은 1을 «빌려오게» 되므로, 접두사 전체가 1이 됩니다. 답에서 이 위치에는 반드시 1이 옵니다.
- 그다음에는 이 접두사의 비트 중에서 원래 수에서 1이었던 비트들이 정확히 상쇄됩니다.
예시:
$$ \begin{aligned} +90 = 2+8+16+64 & = 0 \, 10110_2 \\ -90 = 00000_2 - 10110_2 & = 1 \, 01010_2 \\ \implies (+90) \& (-90) & = 0 \, 00010_2 \end{aligned} $$이제 우리의 보조정리를 증명할 수 있습니다. & 연산을 하면, 최하위 1 비트 앞의 접두사에서는 x와 -x의 모든 비트가 서로 반대이고, 최하위 1 비트는 1로 남으며, 접미사에서는 모든 비트가 원래 0이었던 그대로 남습니다. 따라서 바로 이 최하위 1 비트만 「살아남으며」, 이것이 우리가 증명하려던 것입니다.
따름정리 1. sum은 로그 시간, 더 정확히는 $x$의 이진 표기에서 1인 비트의 개수에 비례하는 시간에 동작합니다. 각 반복마다 x -= x & -x를 수행하는데, 이는 최하위 비트를 제거하는 것입니다.
따름정리 2. add 역시 로그 시간에 동작합니다. 각 반복마다 $x$의 끝에 있는 0의 개수가 적어도 하나씩 늘어나기 때문입니다.
따름정리 3. (펜윅 트리가 왜 트리인가.)
임의의 $t_i$에 대응하는 구간의 길이는 2의 거듭제곱이며, 이 구간은 그와 같은 2의 거듭제곱의 배수인 인덱스에서 시작합니다.
$\implies$ 임의의 $t_i$와 $t_j$에 반영된 원소들의 집합은 서로 겹치지 않거나, 한쪽이 다른 쪽의 부분집합입니다.
$\implies$ $t_i$에 대해 포함 관계를 정의할 수 있습니다.
즉, 상상력을 조금 발휘하면 $t$를 트리들의 숲으로 볼 수 있습니다. $n$이 2의 거듭제곱인 특수한 경우에는 트리가 하나뿐입니다.
이제 남은 것은 add의 정확성을 증명하는 것뿐입니다. 사실 add에서 우리가 하는 일은 정점에서 루트까지 모든 조상을 따라 올라가는 것에 불과합니다.
$x$의 직접적인 부모는 어떻게 찾을 수 있습니까? $t_y$가 $x$를 포함하는 최소의 수 $y > x$를 찾아야 합니다. 다시 말해, y >= x > y - (y & -y)가 성립해야 합니다.
이제 독자 여러분은 직접 예시를 들여다보면서 x + (x & -x)가 그러한 최소의 수라는 것을 확인해 보시기 바랍니다: