스위프 라인 기법(영어 scanline)은 좌표 직선 위의 점들 또는 어떤 추상적인 «이벤트»들을 어떤 기준에 따라 정렬한 뒤 차례로 순회하는 방법입니다.
이 방법은 모든 쿼리를 미리 알고 있을 때 자료 구조 문제를 해결하는 데 자주 사용되며, 기하학에서 도형들의 합집합을 구하는 데에도 사용됩니다.
#가장 많은 선분에 덮인 점
문제. 직선 위에 시작점과 끝점의 좌표 $[l_i, r_i]$로 주어진 $n$개의 선분 집합이 주어집니다. 가장 많은 수의 선분에 덮이는 직선 위의 점을 아무거나 하나 찾아야 합니다.
점 $x$를 덮는 선분의 개수와 같은 함수 $f(x)$를 생각해 봅시다. 이 함수의 모든 점을 하나하나 확인할 수는 없다는 것이 분명합니다.
자신을 덮는 선분의 개수가 바뀌는 점들을 흥미로운 점이라고 부릅시다. 답의 변화는 흥미로운 점에서만 일어날 수 있으므로, 최댓값 역시 흥미로운 점 중 어딘가에서 달성됩니다. 이로부터 곧바로 $O(n^2)$ 풀이가 나옵니다. 모든 흥미로운 점(주어진 선분들의 끝점이 됩니다)을 하나씩 살펴보면서 각 점에 대해 따로 답을 확인하면 됩니다.
이 풀이는 개선할 수 있습니다. 흥미로운 점들을 좌표의 오름차순으로 정렬하고 왼쪽에서 오른쪽으로 차례로 지나가면서, 현재 점을 덮는 선분의 개수 cnt를 유지합시다. 현재 점에서 선분이 시작되면 cnt를 1 증가시키고, 선분이 끝나면 1 감소시켜야 합니다. 그런 다음 현재 cnt 값으로 문제의 답을 갱신해 봅니다.
구현 방법은 다음과 같습니다. 관심 있는 점들을 ‘좌표’와 ‘유형’(시작 / 끝) 필드를 가진 구조체로 표현하고, 직접 정의한 비교자로 정렬해야 합니다. 선분의 시작을 +1로, 끝을 -1로 나타내면 편리합니다. 그러면 이 값을 cnt에 그대로 더하기만 하면 되고 경우를 나눌 필요가 없습니다.
유일하게 주의할 점은, 두 점의 좌표가 같을 때 올바른 답을 얻으려면 먼저 모든 선분의 시작점을 처리한 다음에 끝점을 처리해야 한다는 것입니다(그래야 이 좌표에서 답을 갱신할 때 오른쪽 경계 선분과 왼쪽 경계 선분이 모두 반영됩니다).
struct event {
    int x, type;
};

int scanline(vector<pair<int, int>> segments) {
    vector<event> events;

    for (auto [l, r] : segments) {
        events.push_back({l, 1});
        events.push_back({r, -1});
    }

    sort(events.begin(), events.end(), [](event a, event b) {
        return (a.x < b.x || (a.x == b.x && a.type > b.type));
    });

    int cnt = 0, res = 0;

    for (event e : events) {
        cnt += e.type;
        res = max(res, cnt);
    }

    return res;
}
이 풀이는 정렬에 드는 $O(n \log n)$ 시간에 동작합니다. 좌표가 작다면, 서로 다른 각 좌표마다 이벤트를 담는 vector를 만들고 모든 정수 좌표와 그 안의 이벤트를 단순히 순회하는 방식으로 로그 인자를 없앨 수 있습니다. 또한 좌표를 압축하는 것은 언제나 좋은 생각입니다.
이제 몇 가지 관련 문제를 살펴봅시다.
#선분 합집합의 길이
문제. 직선 위에 시작점과 끝점의 좌표 $[l_i, r_i]$로 주어진 $n$개의 선분 집합이 있습니다. 이 선분들의 합집합의 전체 길이를 구해야 합니다.
이전 문제와 마찬가지로, 모든 관심 있는 점들을 정렬하고 순회하면서 현재 점을 덮는 선분의 개수를 유지합시다. 그 개수가 0보다 크면, 직전에 살펴본 점에서부터 지나온 구간은 합집합에 속하므로 그 길이를 답에 더해야 합니다:
int cnt = 0, res = 0, prev = -inf;

for (event e : events) {
    if (prev != -inf && cnt > 0)
        res += e.x - prev; // весь отрезок [prev, e.x] покрыт cnt отрезками
    cnt += e.type;
    prev = e.x;
}
실행 시간은 $O(n \log n)$입니다.
#한 점이 몇 개의 선분에 속하는가
이제 $q$개의 점(반드시 선분의 끝점일 필요는 없습니다)에 대해 다음 질문에 답해야 한다고 합시다. 주어진 점은 몇 개의 선분에 속합니까?
다음과 같은 기법을 사용합시다. 모든 쿼리를 한꺼번에 읽어 저장해 두었다가 나중에 한 번에 모두 답하는 것입니다. 쿼리 점들을 새로운 유형 0의 이벤트로 추가합시다. 이 유형은 해당 점에서 쿼리에 답해야 한다는 것을 의미하며, 쿼리 번호를 위한 별도의 필드를 가집니다.
이제 마찬가지로 관심 지점들을 정렬하고 왼쪽에서 오른쪽으로 순회하면서 cnt를 유지하고, 쿼리를 만나면 그때 답합니다.
struct event {
    int x, type, idx;
};

void scanline(vector<pair<int, int>> segments, vector<int> queries) {
    int q = (int) queries.size();

    vector<int> ans(q)
    vector<event> events;

    for (auto [l, r] : segments) {
        events.push_back({l, 1});
        events.push_back({r, -1});
    }

    for (int i = 0; i < q; i++)
        events.push_back({queries[i], 0, i});

    // при равенстве координат сначала идут добавления, потом запросы, потом удаления
    sort(events.begin(), events.end(), [](event a, event b) {
        return (a.x < b.x || (a.x == b.x && a.type > b.type));
    });

    int cnt = 0;

    for (event e : events) {
        cnt += e.type;
        if (e.type == 0)
            ans[e.idx] = cnt;
    }
}
시간 복잡도는 $O((n+q)\log(n+q))$입니다.
#교차하는 선분의 개수
문제. 직선 위에 시작점과 끝점의 좌표 $[l_i, r_i]$로 주어진 $n$개의 선분 집합이 있습니다. 각 선분에 대해 그 선분이 몇 개의 선분과 교차하는지 구해야 합니다(특히, 한 점만 공유하거나 다른 선분에 포함되는 경우도 교차하는 것으로 봅니다).
각 선분에 대해 그 선분과 교차하는 선분의 개수를 세는 대신, 교차하지 않는 선분의 개수를 세고 이 수를 $(n-1)$에서 뺍시다.
구간 $[l_1, r_1]$은 $r_2 < l_1$이거나 $r_1 < l_2$인 경우에만 다른 구간 $[l_2, r_2]$와 교차하지 않습니다. 각 경우에 대해 구간의 개수를 세어 봅시다. 일반성을 잃지 않고 첫 번째 경우를 살펴봅시다. 즉, 각 구간에 대해 그 구간보다 엄격하게 왼쪽에 놓인 구간의 개수를 구합니다. 이를 위해 두 가지 유형의 이벤트를 도입해야 합니다.
- 어떤 선분이 좌표 $r_i$에서 끝났습니다.
- 어떤 인덱스를 가진 어떤 선분이 좌표 $l_j$에서 시작되었습니다.
이제 이 이벤트들을 왼쪽에서 오른쪽으로 차례로 훑으면서, 지금까지 만난 첫 번째 유형 이벤트의 개수를 유지하고, 두 번째 유형 이벤트에서는 이 개수를 해당 답 칸에서 빼기만 하면 됩니다.
마찬가지로 오른쪽에서 왼쪽으로 지나가면서 엄밀히 오른쪽에 놓인 선분들을 찾습니다. 최종 실행 시간은 정렬에 드는 $O(n \log n)$입니다.
#직사각형 위의 합
이제 2차원 스캔라인으로 넘어갑시다.
문제. 평면 위에 $n$개의 점이 주어집니다. 직사각형 안에 있는 점의 개수를 묻는 $m$개의 쿼리에 답해야 합니다.
먼저 모든 좌표(점과 쿼리 모두)를 압축합시다. 즉, 좌표가 모두 $O(n + m)$ 범위라고 가정하겠습니다.
이제 각 쿼리를 접두사 합 쿼리 두 개로 나눕시다. 직사각형 $[x_1, x_2] \times [y_1, y_2]$에서의 합은 직사각형 $[0, x_2] \times [y_1, y_2]$에서의 합에서 직사각형 $[0, x_1] \times [y_1, y_2]$에서의 합을 뺀 것과 같습니다.
합에 대한 세그먼트 트리와 쿼리의 답을 저장할 배열 ans를 만듭시다. 이제 관심 있는 모든 $x$, 즉 점들의 좌표와 접두사 쿼리의 오른쪽 경계를 증가하는 순서로 차례대로 살펴보면서 세 가지 유형의 이벤트를 처리합니다:
- 점을 만나면 세그먼트 트리의 $y$번 칸에 1을 더합니다.
- «왼쪽» 누적 합 쿼리를 만나면, 세그먼트 트리로 구간 $[y_1, y_2]$의 합을 계산하여 답 칸에서 뺍니다.
- «오른쪽» 쿼리를 만나면, 마찬가지로 $[y_1, y_2]$ 구간의 합을 답 칸에 더합니다.
따라서 이 문제를 오프라인으로 $O(n \log n)$에 해결합니다. 좌표 압축 또는 정렬에 더해 세그먼트 트리(또는 동적 합을 지원하는 다른 자료 구조)에 $O(n)$개의 쿼리를 수행하면 됩니다.
보조 부분 문제로서의 직사각형 합은 순열의 역순쌍 문제나 서브트리 쿼리 문제에서도 자주 사용됩니다.
#직사각형 합집합의 넓이
문제. $n$개의 직사각형이 주어질 때, 이들의 합집합의 넓이를 구해야 합니다.
앞의 접근 방식에서 착안하여 두 가지 유형의 이벤트를 만들 수 있습니다.
- $y$-좌표가 $y_1$부터 $y_2$까지인 직사각형이 점 $x_1$에서 시작합니다;
- $y$-좌표가 $y_1$부터 $y_2$까지인 직사각형이 점 $x_2$에서 끝납니다;
그런 다음 이 이벤트들을 $x$가 증가하는 순서로 어떻게든 훑으면서, 1차원 선분에서 했던 것과 비슷한 방식으로 전체 넓이를 계산합니다.
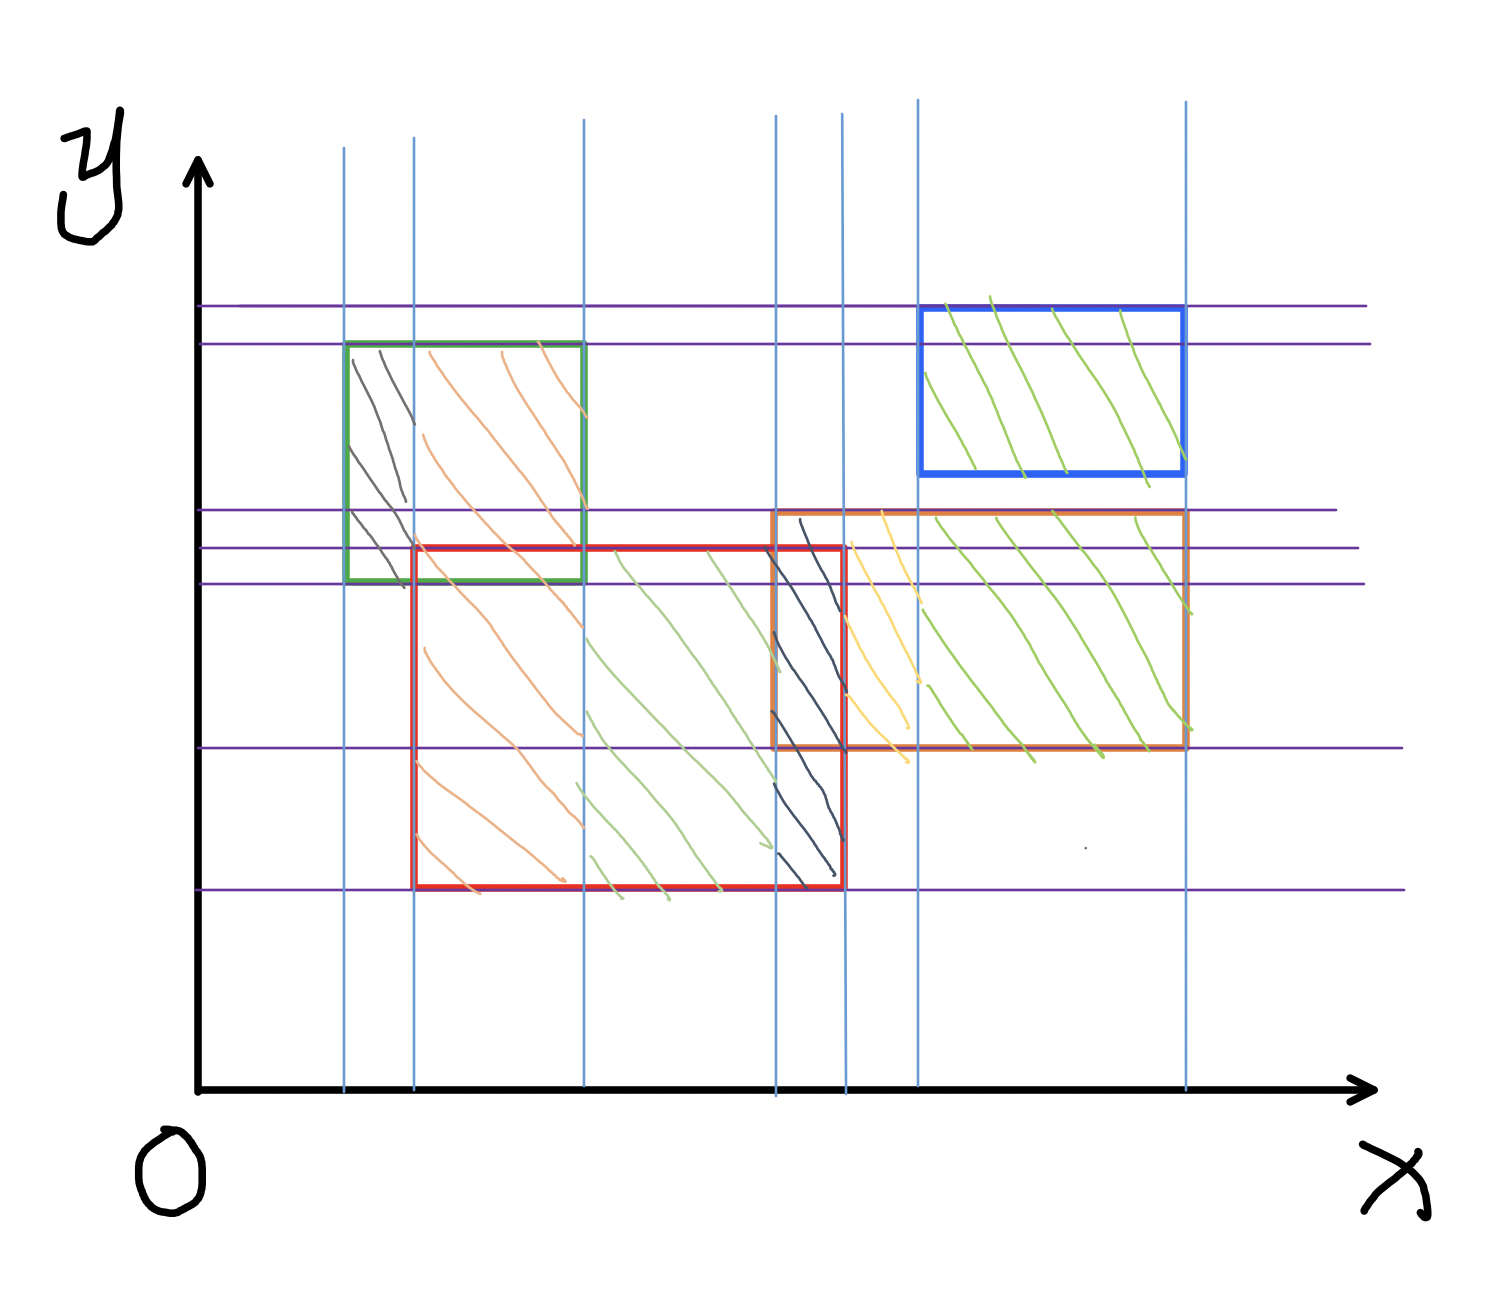
이 접근법을 그대로 일반화하면, 크기가 $Y$(최대 $y$좌표)인 배열을 만들고 각 $y$-평행선마다 그것을 덮는 직사각형의 개수를 관리해야 하며, 이벤트의 $x$좌표가 바뀔 때마다 이전 이벤트와 새 이벤트의 $x$좌표 차이에 배열의 0이 아닌 원소 개수(수직 스위프 라인 위의 점 중 적어도 하나의 직사각형에 덮이는 점의 개수)를 곱한 값을 답에 더해야 합니다.
하지만 이 방법은 최악의 경우 $O(nY)$ 시간에 동작하므로 꽤 느립니다. 더 나은 점근적 복잡도를 얻기 위해, 배열을 세그먼트 트리로 바꿉시다. 이 트리의 각 노드에는 최솟값과 그 최솟값을 갖는 원소의 개수를 저장합니다(처음에는 최솟값이 0이고, 배열 전체에서 그러한 원소는 $Y$개입니다).
답을 갱신하려면 인접한 이벤트의 $x$좌표 차이에 0이 아닌 원소의 개수를 곱해야 하며, 이 개수는 $Y$에서 트리 전체에서 최솟값이 0인 원소의 개수를 빼서 구할 수 있습니다. 구간에 값을 더할 때 이 정보를 다시 계산하는 1차원 문제는 독자의 연습 문제로 남겨 둡니다.
이러한 알고리즘은 좌표를 신중하게 압축하면 $O(n \log n)$에, 그렇게 하지 않으면 $O(n \log Y)$에 동작합니다. 이 방법은 다른 기하 도형의 넓이를 구하는 문제로도 일반화됩니다.