$O(2^n \cdot poly(n))$에 풀 수 있는 부분집합 전체 탐색 문제를 하나 생각해 봅시다. 여기서 $poly(n)$은 문제 크기 $n$에 대한 어떤 다항식입니다. meet-in-the-middle 기법(직역하면 「중간에서 만나기」)을 사용하면 이러한 문제의 넓은 부류에서 전체 탐색을 $O(2^{n/2} \cdot poly(n))$까지 최적화할 수 있습니다.
구체적인 예로 배낭 문제를 살펴봅시다. 총 무게가 $w$인 $a_i$의 부분집합을 골라야 합니다:
bool find_subset(int *a, int n, int w)
    for (int mask = 0; mask < (1 << n); mask++) {
        int s = 0;
        for (int i = 0; i < n; i++)
            if (mask >> i & 1)
                s += a[i];
        if (s == w)
            return true;
    }
    return false;
}
여기서는 모든 부분집합을 순회하며 각각을 $O(n)$에 검사하므로, 점근적 복잡도는 $O(2^n \cdot n)$입니다.
이론적으로는 마스크를 재귀적으로 순회하면서 접두사의 현재 합을 유지하고, 내려가는 동안 원소를 많아야 하나만 추가하면 $O(n)$ 검사를 없앨 수 있습니다. 하지만 우리는 더 강력한 최적화를 추구하겠습니다.
#풀이
배열을 두 부분으로 나눕시다. 찾고자 하는 부분집합은 왼쪽 절반의 원소 몇 개와 오른쪽 절반의 원소 몇 개(0개일 수도 있습니다)로 이루어져 있다는 점에 주목하십시오. 왼쪽과 오른쪽의 모든 합을 각각 따로 계산한 뒤, 원하는 전체 합을 만드는 쌍을 찾아봅시다.
먼저 처음 $l = \lfloor \frac{n}{2} \rfloor$개 원소의 모든 부분집합에 대해 합을 계산하여 해시 테이블에 넣습니다:
unordered_set<int> t;

int l = n / 2;

for (int mask = 0; mask < (1 << l); mask++) {
    int s = 0;
    for (int i = 0; i < n; i++)
        if (mask >> i & 1)
            s += a[i];
    t.insert(s);
}
그다음 나머지 $r = n - l = \lceil \frac{n}{2} \rceil$개 원소의 모든 합을 순회하면서, 각 합에 대해 미리 계산해 둔 해시 테이블을 이용해 짝이 맞는 나머지 절반(합이 $s_l = w - s_r$인 것)을 찾습니다:
int r = n - l;

for (int mask = 0; mask < (1 << r); mask++) {
    int s = 0;
    for (int i = 0; i < r; i++)
        if (mask >> i & 1)
            s += a[l + i];
    if (t.count(w - s))
        return true;
}
두 단계 모두(따라서 알고리즘 자체도) $O(2^{n/2} \cdot n)$에 동작합니다. $2^{n/2}$개의 부분집합을 순회하면서 각 부분집합마다 $O(n)$에 합을 계산하고, 해시 테이블에 $O(1)$의 추가 / 존재 여부 확인 요청을 수행하기 때문입니다.
두 전수 탐색 모두 재귀를 이용한 기법으로 마찬가지로 $O(n)$배 더 최적화할 수 있다는 점에 주목하십시오.
#다른 예시
문제. $10^{14}$ 이하의 수 중 자릿수의 합이 $s$인 수의 개수를 구하십시오.
수를 왼쪽 부분(상위 7자리)과 오른쪽 부분(하위 7자리)으로 나눕시다. 왼쪽 부분의 모든 수에 대해 그중 몇 개가 합 $s$를 가지는지 미리 계산하여 전처리 배열에 기록합니다(배열의 크기는 $7 \times 9 + 1 = 64$입니다). 그다음 오른쪽 부분을 순회하면, “왼쪽” 합 $s$에 대해 합이 $(w - s)$인 오른쪽 부분의 개수를 구해야 하는데, 이는 미리 계산한 배열을 $O(1)$에 참조하기만 하면 됩니다.
제약 조건이 클 때 이 문제는 자릿수 DP로 풉니다.
문제. $n$개의 정점으로 이루어진 그래프가 주어집니다. 클리크, 즉 모든 정점이 서로 연결된 부분 그래프의 개수를 구해야 합니다.
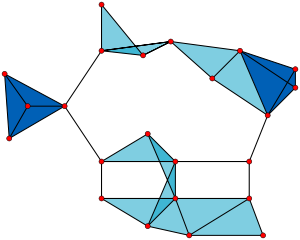
먼저 완전 탐색으로 문제를 푸는 방법을 알아봅시다. 그래프의 인접 행렬이 주어져 있다고 합시다. 정점 부분집합 $m$이 클릭인지 어떻게 빠르게 확인할 수 있습니까?
$O(n^2)$에 포함된 정점의 모든 쌍을 순회하면서, 각 쌍에 대해 인접 행렬에 1이 있는지 확인할 수 있습니다. $m$의 정점들에 대응하는 인접 행렬 행들의 비트 단위 «AND»와 같은 마스크 $m’$을 계산하면 확인을 $O(n)$까지 최적화할 수 있습니다. 이제 $m$이 $m’$의 부분집합이라면, 즉
$$ m \; \& \; m' = m $$부분 그래프 $m$은 클리크입니다. 즉, 그 모든 정점에 대해 다른 모든 정점으로부터 간선이 있습니다.
이 트릭을 meet-in-the-middle에서 답을 합치는 데 사용해 봅시다. 그래프를 두 부분으로 나누고, 왼쪽 부분의 모든 클릭을 찾은 다음 크기가 $2^{n/2}$인 특별한 배열 is_clique[mask]에서 그 마스크들을 1로 표시합니다.
이제 두 번째 절반의 부분 그래프를 순회하면서, 각 클릭마다 오른쪽 절반에 대한 인접 리스트들의 교집합(위의 검사에서의 $m’$)의 부분 그래프인 왼쪽 절반의 클릭 개수를 구해야 합니다.
이를 빠르게 하기 위해 is_clique 배열 위에 “주어진 마스크의 부분 마스크 중 몇 개가 클릭인가"를 나타내는 DP를 미리 계산합시다. 각 마스크 $m$에 대해 첫 번째 정점 $v$가 클릭에 포함되는 경우와 포함되지 않는 경우의 두 가지를 고려하면 이 DP를 $O(2^{n/2})$에 계산할 수 있습니다:
알고리즘의 최종 시간 복잡도는 $O(2^{n/2} \cdot n)$입니다.
문제. 각 정점에서 나가는 간선이 최대 $k$개인 매우 큰 가중치 없는 그래프가 암시적으로 주어집니다. $s$에서 $t$까지의 거리가 $n$을 넘지 않는다는 것이 알려져 있을 때, 그 거리를 구해야 합니다.
두 정점에서 동시에 너비 우선 탐색을 실행하고, 각 탐색에서 찾은 $s$ 또는 $t$로부터의 거리를 정점 옆에 기록합시다. 한쪽의 탐색이 다른 쪽 탐색이 방문한 정점에 들어가면, 길이 $(d_s + d_t)$의 경로를 복원하고 종료합니다.
거리가 $n$을 넘지 않으므로, 알고리즘은 $O(\frac{n}{2})$번의 «파동» 안에 반드시 종료됩니다. 각 정점은 최대 $k$개의 다른 정점과 연결되어 있고 알고리즘은 «부모»로 들어가지 않으므로, 다음 파동의 정점 수는 이전 파동보다 최대 $(k-1)$배 많습니다.
따라서 총 $O((k-1)^{n/2})$개의 정점을 방문하게 되며, 이것이 곧 알고리즘의 점근적 복잡도가 됩니다.