앞서 언급했듯이, 자비스 알고리즘이 $O(n^2)$가 아니라 $O(nh)$에 동작한다는 점이 때로는 중요한 역할을 합니다. 껍질이 작다는 것을 알고 있을 때에는 $O(n \log n)$에 동작하는 그레이엄 알고리즘보다 자비스 알고리즘이 더 낫습니다.
챈 알고리즘은 두 알고리즘의 장점을 취해 자비스 알고리즘과 그레이엄 알고리즘을 결합함으로써 $O(n \log h)$의 점근적 복잡도를 얻으려고 합니다.
알고리즘. 모든 점을 $m$개씩 묶어 그룹으로 나눕니다. 각 그룹에서 그레이엄 알고리즘으로 $O(m \log m)$ 시간에 볼록 껍질을 구합니다. 점들은 아무런 순서로도 정렬되어 있지 않으며, 이 껍질들은 서로 겹칠 수 있는데, 이는 문제가 되지 않습니다. 모든 그룹에 대해 합산하면 $O(n \log m)$번의 연산이 필요합니다.
그런 다음, 가장 왼쪽 아래 점에서 시작하여 자비스 알고리즘과 같은 방식으로 전체 볼록 껍질을 만들어 나갑니다. 다만 이번에는 $\frac{n}{m}$개의 껍질 각각에서 이진 탐색을 수행하면 매번 “가장 오른쪽 점"을 $O(n)$이 아니라 $O(\frac{n}{m} \log m)$에 찾을 수 있습니다.
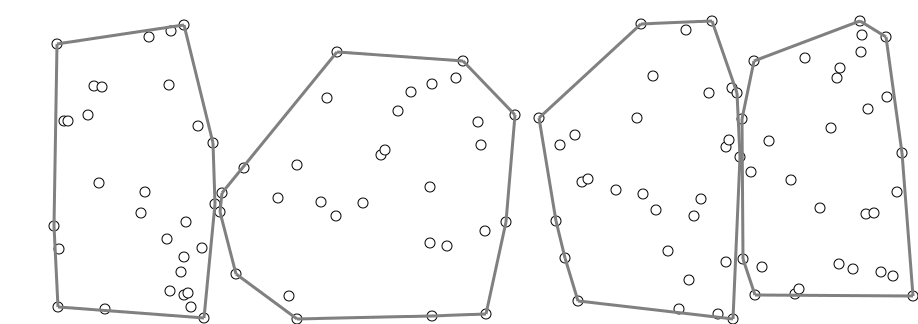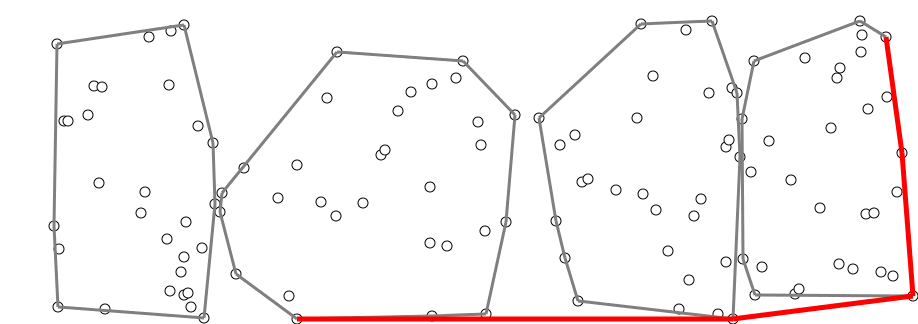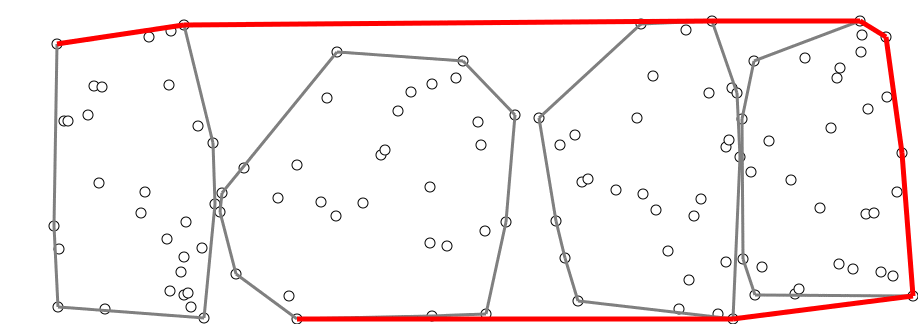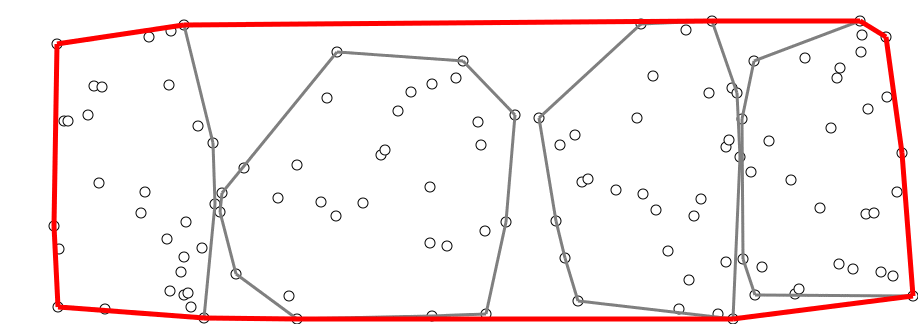
결과적으로 이러한 풀이는 $O(h \frac{n}{m} \log m + n \log m)$에 동작합니다. $h$를 미리 대략적으로 알고 있다면 $m = h$로 둘 수 있으며, 그러면 시간 복잡도는 $O(n \log h)$가 됩니다.
실제로 적용될 만한 어떤 제약 조건에서도, 심지어 껍질이 세 개의 점으로 이루어져 있더라도 이 알고리즘이 일반적인 그레이엄 알고리즘보다 빠르지 않을 것임은 분명하므로, 저자는 이 알고리즘의 구현을 제시하지 않겠습니다. 이 방법은 단지 이론적인 관점에서 흥미로울 뿐입니다.
연습 문제. $h$를 모르는 상태에서 점근적 복잡도가 $O(n \log h)$로 유지되도록 $m$을 고르는 방법을 생각해 보십시오.