힙(영어: heap)은 다음 연산을 지원하는 추상 자료 구조입니다:
- 최솟값 찾기.
- 최솟값 삭제.
- 힙에 새 원소 추가.
기능을 더 잘 반영하는 다른 이름은 우선순위 큐(영어: priority queue)입니다.
힙은 많은 알고리즘에서 사용됩니다. 예를 들어, 힙은 최단 경로 탐색 알고리즘에 사용되며, 힙을 이용하여 정렬을 수행할 수도 있습니다(배열을 힙으로 변환한 다음, 힙을 정렬된 배열로 변환하는 방식입니다).
#이진 힙의 구조
이진 힙(피라미드, 정렬 트리, 영어: binary heap)은 다음 세 가지 조건을 만족하는 루트 트리를 사용하는 우선순위 큐의 구현입니다.
- 모든 정점의 값은 그 자손들의 값보다 크지 않습니다.
- 모든 정점은 자식을 최대 두 개까지 가집니다.
- 층은 위에서 아래로, 왼쪽에서 오른쪽으로 «빈틈» 없이 차례대로 채워집니다.
이진 힙은 유일하게 만들어지지 않는다는 점에 주목합시다. 예를 들어, 리프인 자식들의 값은 언제나 서로 바꿀 수 있습니다. 고정되어 있는 것은 구조 자체와 “부모는 자식보다 크지 않다"라는 술어뿐입니다.
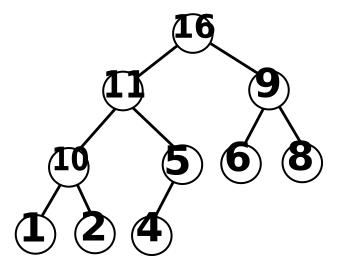
트리의 높이를 $h$라고 합시다. 힙은 항상 완전히 채워진 여러 개의 층과 부분적으로 채워진 하나의 층으로 이루어져 있고, 각 층은 이전 층보다 두 배 많은 정점을 포함하므로, 트리의 높이는 $\Theta(\log n)$이 됩니다.
다른 모든 우선순위 큐와 마찬가지로, 이진 힙은 다음 연산을 수행할 수 있어야 합니다:
- $O(1)$에 최솟값 찾기.
- $O(h)$에 최솟값 삭제.
- $O(h)$ 시간에 힙에 새 원소 추가.
기본 세 가지 외에도 “키 값 변경"과 같은 다른 연산을 정의할 수 있지만, 지금은 이 세 가지만 다루겠습니다.
#구현
힙은 배열 $t$의 형태로 저장하며, 루트의 인덱스는 $1$이고 정점 $k$의 자식들의 인덱스는 $2k$와 $(2k + 1)$입니다. 이때 배열의 0번째 칸은 비어 있는 상태로 둡니다.
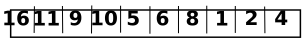
다음으로, 한 원소의 값이 바뀔 때 힙의 불변식을 복원하는 두 가지 보조 함수를 정의합니다.
원소의 값이 감소하면, 힙의 첫 번째 조건이 성립하도록 그 원소를 위로 옮겨야 할 수도 있습니다. 이는 원소의 직속 부모의 값이 더 크다면 원소를 부모와 맞바꾸는 과정을 여러 번 반복하여 수행할 수 있습니다. 매번 트리를 한 단계씩 올라가므로, 이 함수는 트리의 높이에 비례하는 시간에 동작합니다:
void sift_up(int v) {
    // если элемент больше своего отца, то всё корректно и больше ничего делать не нужно
    while (v > 1 && t[v] < t[v / 2]) {
        // иначе меняем его с отцом и запускаемся от отца
        swap(t[v], t[v / 2]);
        v /= 2;
    }
}
변경된 원소의 값이 증가하면, 반대로 그 원소를 아래로 옮겨야 합니다. 이는 비슷한 방법으로, 원소를 자식 중 더 작은 쪽과 반복적으로 교환하고 그 자식 위치에서 계속 진행하는 식으로 할 수 있습니다. 마찬가지로 매번 한 단계씩 더 깊이 내려가므로, 이 과정 역시 트리의 높이만큼의 시간에 동작합니다:
void sift_down(int v) {
    // пока не пришли в лист
    while (2 * v <= n) { // n -- количество элементов в куче
        int l = 2 * v; // левый сын
        int r = 2 * v + 1; // правый сын
        // если правый сын существует и меньше, выбираем его
        int u = (r <= n && t[r] < t[l] ? r : l);
        if (t[v] <= t[u])
            break; // инвариант и так выполняется, завершаемся
        swap(t[v], t[u]);
        v = u;
   }
}
이해를 돕기 위해 시각화 자료를 살펴보시기를 권합니다.
이제 「유용한」 연산으로 돌아가 봅시다:
- 최솟값 조회는 루트, 즉 배열의 첫 번째 원소를 그대로 반환하기만 하면 되므로 상수 시간에 수행할 수 있습니다.
- 최솟값을 삭제하려면 루트의 값을 배열의 마지막 원소의 값으로 바꾸고, 힙의 크기를 줄인 다음, 루트에서
sift_down을 실행하면 됩니다. - 원소를 추가하려면 배열의 끝에 원소를 추가한 다음, 그 원소에서
sift_up을 호출합니다.
참고. 이진 힙이 아니라 각 정점이 최대 $d$개의 자식을 가질 수 있는 이른바 $d$-힙을 생각하더라도, 임의의 상수 $d$에 대해 실행 시간은 그대로 유지됩니다.
#선형 시간 구성
$n$개의 원소로 이루어진 집합에 대한 힙은 원소를 하나씩 추가하기만 해도 구축할 수 있습니다. 이러한 구축 알고리즘은 $O(n \log n)$에 동작하며, 대부분의 경우 이 정도면 충분히 빠릅니다. 하지만 이를 조금 더 빠르게, 즉 선형 시간에 수행할 수도 있습니다.
사실 우리가 원하는 것은 단지 어떤 배열 $t$의 원소들을 재배열하여, 모든 인덱스 $1 \le i \le n$에 대해 부등식 $t_i \le t_{2 i}$와 $t_i \le t_{2 i + 1}$이 성립하도록 하는 것입니다(물론 해당 원소들이 존재하는 경우에 한합니다).
그렇다면 이 힙 속성을 끝에서부터 복원해 봅시다. 아래로 거르기(sift_down)를 이용해 속성이 성립하는 접미사를 점차 늘려 나가겠습니다. 다음과 같은 알고리즘을 얻습니다:
void build_heap() {
    for (int i = n; i > 0; --i) {
        // для суффикса t[i + 1 .. n] свойство кучи выполняется
        sift_down(i);
        // теперь выполняется для суффикса t[i .. n]
    }
}
이것이 왜 $O(n)$에 동작합니까? 아래로 내리기(sift down)의 총횟수를 위에서부터 정직하게 상한으로 추정해 봅시다. 각 높이 $i$마다 그 높이에 있는 정점은 $2^{h - i}$개를 넘지 않으므로,
$$ \sum_{i = 1}^h 2^{h - i} \cdot i = 2^{h + 1} - h - 2 \le 2 n - h - 2 \le 2 n = O(n) $$첫 번째 등식은 $h$에 대한 귀납법으로 쉽게 증명됩니다.
#표준 라이브러리에서
STL에는 배열 위에서 이진 힙을 다루기 위한 여러 기본 연산이 제공됩니다:
int ints[] = {10,20,30,5,15};
vector<int> v(ints, ints + 5);

make_heap(v.begin(), v.end());
v.front(); // получить максимальный элемент (30)

pop_heap(v.begin(), v.end()); // удалить максимум из кучи
v.pop_back(); // уменьшить размер массива на единицу

v.push_back(99); // добавить элемент в конец массива
push_heap(v.begin(), v.end()); // вызовет sift_up от последнего элемента

sort_heap(v.begin(), v.end()); // сортировка кучей: в v будет записан отсортированный массив
하지만 이들을 직접 사용하는 경우는 상당히 드뭅니다. 그보다는 벡터와 이 연산들 위에 구축된 인터페이스를 더 자주 사용하며, 이는 priority_queue로 제공됩니다:
priority_queue<int> q;

for (int x : {1,5,3,4,2,0})
    q.push(x);

q.top(); // вернуть максимальный элемент (5)
q.pop(); // удалить максимальный элемент
priority_queue에서 (기본적으로) 최댓값 원소를 찾는 연산은 $O(1)$에 동작하며, 추가와 삭제는 $O(\log n)$에 동작합니다. 이 외에도 .size(), .empty()를 비롯하여 STL 컨테이너에 기대되는 나머지 모든 메서드를 갖추고 있습니다.
또한 우선순위 큐로 std::set과 같은 임의의 탐색 트리를 사용하는 경우도 많습니다.