1차원 정수 배열의 합을 구하는 다음 프로그램을 살펴봅시다:
#pragma GCC optimize("O3")
// ^ включает самый "агрессивный" уровень оптимизации
// то же самое, что добавить флаг "-O3" при компиляции из консоли

#include <iostream>
using namespace std;

const int n = 1e5;
int a[n], s = 0;

int main() {
    for (int t = 0; t < 100000; t++)
        for (int i = 0; i < n; i++)
            s += a[i];

    return 0;
}
이 코드를 아무런 추가 설정 없이 GCC로 컴파일하여 실행하면 2.43초 만에 실행이 끝납니다.
이제 프로그램의 맨 앞부분에 다음과 같은 마법의 지시문을 추가해 봅시다:
#pragma GCC target("avx2")
// ...остальное в точности как было
같은 조건에서 컴파일하고 실행하면, 프로그램은 이제 1.24초 만에 종료됩니다. 코드 자체와 최적화 수준은 바꾸지 않았는데도 거의 두 배 빨라진 것입니다.
이는 현대 프로세서에 특별한 ‘벡터’ 명령어가 있기 때문입니다. 이 명령어는 한 번에 스칼라 하나에만 연산을 적용하는 것이 아니라, 연속된 여러 원소로 이루어진 블록 전체에 하나의 연산을 한꺼번에 적용할 수 있습니다. 이러한 모델을 SIMD 병렬성(영어: single instruction, multiple data)이라고 합니다.
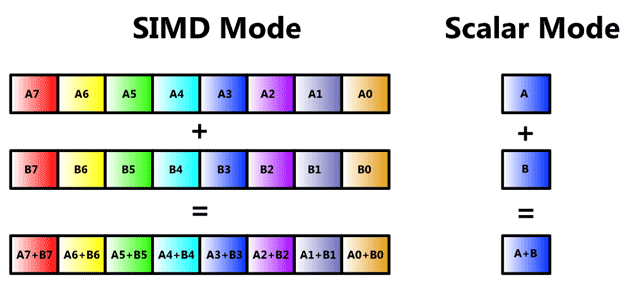
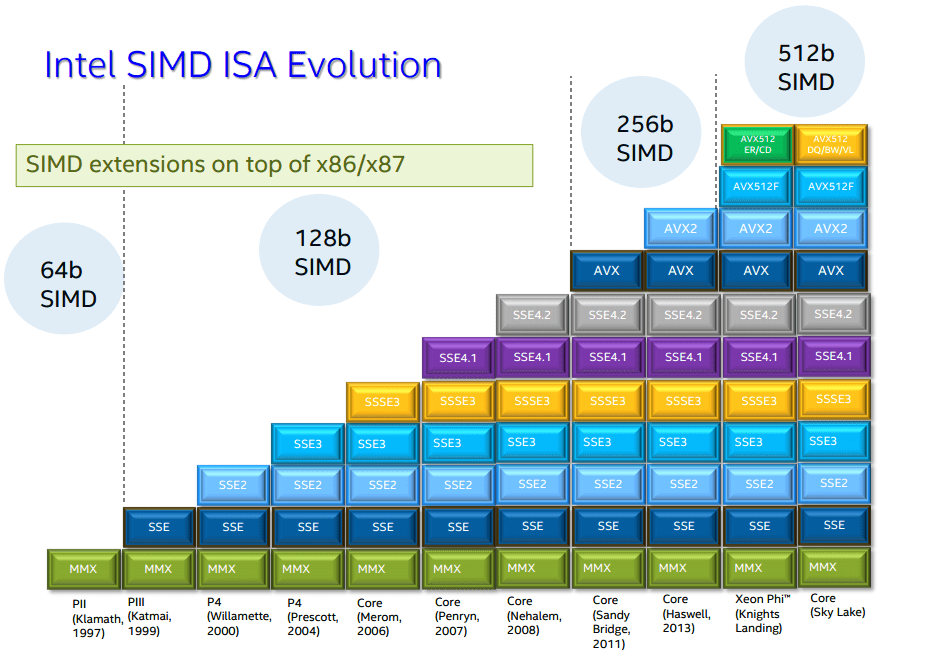
마이크로아키텍처마다 SIMD 명령어 지원 여부가 다릅니다. 명령어 집합 자체뿐만 아니라 벡터 레지스터의 크기도 다르며, 현재는 128비트, 256비트 또는 512비트일 수 있습니다.
x86 아키텍처(대다수의 데스크톱 및 서버 CPU에서 사용됩니다)에서는 모든 SIMD 확장이 대체로 하위 호환성을 유지합니다. 즉, 더 새로운 확장은 그보다 오래된 모든 확장을 포함합니다. 기본적으로 C++ 컴파일러는 타깃(프로그램이 실행될 컴퓨터)이 «SSE2» 명령어 집합을 지원한다는 것만 가정하며, 이는 이번 세기에 등장한 거의 모든 CPU에 해당할 것입니다.
반면 대부분의 최신 CPU는 AVX2를 지원합니다. AVX2의 핵심적인 차이점은 다루는 벡터 레지스터의 크기가 128비트에서 256비트로 두 배 커졌다는 것이며, 따라서 한 번의 연산으로 4개가 아니라 무려 8개의 int를 더할 수 있습니다. 따라서 최적화 컴파일러에 마이크로아키텍처에 대한 추가 정보를 알려 주면(#pragma GCC target("avx2")를 사용하거나 -mavx2, -march=native 같은 플래그를 사용하여), 컴파일러는 더 넓은 레지스터를 사용할 수 있게 되고 프로그램은 예상대로 두 배 빨라집니다.
그러나 벡터화에는 단순히 프라그마를 추가하는 것보다 훨씬 더 많은 미묘한 점이 있습니다. 더 깊이 있게 접근하려면 저자는 「Algorithms for Modern Hardware」의 해당 장을 권장합니다.