다항식에서 0이 아닌 계수 중 차수가 가장 높은 것이 $x^n$의 계수일 때, 그 다항식의 차수는 $n$이라고 합니다.
다항식은 스칼라와 마찬가지로 더하고, 빼고, 곱하여 다른 다항식을 얻을 수 있습니다. 다항식은 나눌 수도 있지만, 그 결과가 항상 다항식이 되는 것은 아닙니다. 이러한 의미에서 다항식의 집합은 모듈로 나머지의 환과 마찬가지로 환입니다.
#다항식과 수의 표현
프로그램에서 다항식을 표현하는 가장 간단한 방법은 계수를 차례대로 담은 vector나 일반 정적 배열을 사용하는 것입니다. 다항식 자체뿐 아니라, $x$가 $10$이나 다른 임의의 진법의 밑과 같다고 간주하면 큰 수도 이러한 형태로 편리하게 표현할 수 있습니다.
긴 수에 대한 연산(예를 들어 곱셈)을 할 때는 다항식에 대해 해당 연산을 수행한 다음, 결과에 캐리를 처리할 수 있습니다. 즉, 얻어진 다항식의 낮은 자릿수부터 높은 자릿수로 차례로 진행하면서 넘친 자릿수를 «올려 보냅니다»:
const int base = 10;

vector<int> normalize(vector<int> a) {
    int carry = 0;
    for (int &x : a) {
        x += carry;
        carry = x / base;
        x %= base;
    }
    while (carry > 0) {
        a.push_back(carry % base);
        carry /= base;
    }
    return a;
}

vector<int> multiply(vector<int> a, vector<int> b) {
    return normalize(poly_multiply(a, b));
}
성능상의 이유로, 기수는 사용하는 자료형에 담을 수 있는 한 최대한 크게 선택해야 합니다(예를 들어 int의 경우 $10^9$ 또는 $2^{30}$).
#전개식의 계수
이항식 $(a+b)$를 $n$제곱할 때 얻어지는 $a^x b^y$의 계수를 이항 계수라고 합니다:
$$ (a + b)^n = \sum_{k=0}^n C_n^k \cdot a^k \cdot b^{n-k} $$ 이 계수들은 다음 공식으로 편리하게 계산할 수 있습니다: $$ C_n^k = \binom{n}{k} = \frac{n!}{(n - k)! k!} $$ 더 일반적인 경우에는 다항 계수를 정의하는데, 이는 괄호 $(a_1+a_2+\ldots+a_k)^n$을 전개했을 때 항 $a_1^{x_1} a_2^{x_2} \ldots a_k^{x_k}$가 나타나는 횟수와 같습니다: $$ P(x_1, x_2, \ldots, x_k) = \frac{n!}{\prod (x_i!)} $$이항 계수는 다항식과 별개로 조합론에서도 사용됩니다. 프로그래밍 문제에서는 이항 계수를 모듈러 연산으로 계산해야 하는 경우가 많으며, 이를 위해서는 팩토리얼의 역원을 구하는 방법을 알아야 합니다.
#다항식의 곱셈
차수가 $n$과 $m$인 두 다항식을 곱하면 차수가 $(n+m)$인 다항식이 됩니다. 다항식의 곱을 구하는 직접적인 공식은 다음과 같습니다.
$$ \left(\sum_{i=0}^n a_i x^i\right)\cdot\left(\sum_{j=0}^m b_j x^j\right)=\sum_{k=0}^{n+m}x^k\sum_{i+j=k}a_i b_j $$이를 단순하게 계산하면 $O(n^2)$번의 연산이 필요하지만, 이 장의 뒷부분에서는 더 효율적인 알고리즘 몇 가지를 살펴보겠습니다. 그중 가장 빠른 알고리즘은 $O(n \log n)$만에 동작합니다.
이 사실을 이용하면 많은 조합론 문제를 다항식의 곱셈과, 이를 계산하는 이미 알려진 알고리즘의 활용으로 환원할 수 있습니다. 이러한 문제의 몇 가지 예를 살펴봅시다.
#2-배낭
크기가 각각 $n$과 $m$인 두 배열 $a$와 $b$가 주어집니다. 가능한 서로 다른 합 $(a_i + b_j)$의 개수를 구해야 합니다.
$n, m, a_i, b_i \le 10^5$.
다항식 $A(x)$와 $B(x)$를 생각해 봅시다. 이 다항식에서 $k$차 항의 계수는 해당 배열에서 $k$와 같은 원소의 개수와 같습니다.
곱 $C = A \cdot B$를 생각해 봅시다. 결과로 얻은 다항식에서 $x^t$의 계수 $c_t$는 다음과 같습니다.
$$ c_t \cdot x^t = \sum_{p+q=t} a_p \cdot b_q \cdot x^{p+q} $$이는 다시 합이 정확히 $t$가 되도록 만드는 방법의 수와 같습니다.
따라서 이 두 다항식을 $O(n \log n)$에 곱한 다음, 결과에서 0이 아닌 계수의 개수를 세기만 하면 됩니다.
#다중 배낭
「Вор в магазине」 문제는 앞의 문제를 약간 변형한 것입니다:
서로 다른 정수 가격 $a_i$를 가진 $n$가지 종류의 물건이 있습니다. 정확히 $k$개의 물건으로 이루어진 묶음(중복 허용)의 가격 합으로 가능한 서로 다른 값의 개수를 구해야 합니다.
$n, k, a_i \le 1000$
다시 한번, $i$차 항의 계수가 가격이 $i$인 물건이 존재하면 1이고 그렇지 않으면 0인 다항식을 생각해 봅시다.
$k=2$이면 우리의 문제는 앞의 문제로 귀결됩니다. 다항식을 자기 자신과 곱한 뒤 0이 아닌 계수의 개수를 세면 됩니다. 일반적인 경우에는 다항식을 $k$제곱한 뒤, 마찬가지로 결과에서 0이 아닌 계수의 개수를 세어야 합니다.
다항식을 순진하게 $k$제곱하면 이 풀이의 시간 복잡도는 $O(n k^2 \log (nk))$입니다. 두 다항식의 곱셈을 $O(k)$번 수행해야 하며, 그중 더 큰 다항식의 길이가 $O(nk)$이기 때문입니다.
다항식의 곱셈은 결합 법칙을 만족하므로 이진 거듭제곱을 사용합시다. 이 경우 시간 복잡도는 $O(nk \log (nk) \log k)$ 이하입니다. 차수가 $O(nk)$인 두 다항식을 $O(\log k)$번 곱해야 하기 때문입니다. 하지만 실제로는 매 반복마다 다항식의 크기가 두 배로 커지므로 시간 복잡도에는 마지막(가장 큰) 곱셈만 반영되며, 따라서 실제 실행 시간은 $O(nk \log (nk))$입니다.
#합성곱
합성곱(영어: convolution)이란 어떤 “창(window)” 함수를 원래 함수의 고정된 길이의 모든 구간에 적용하는 연산을 말합니다.
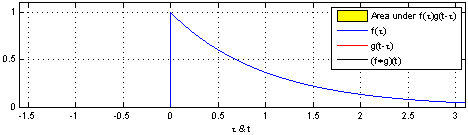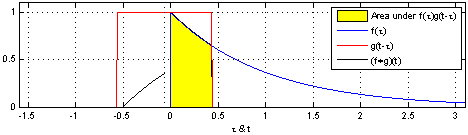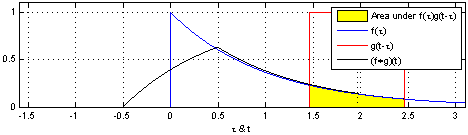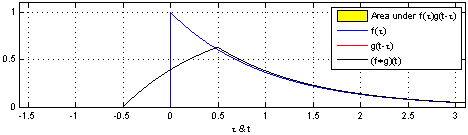
이산적인 경우 합성곱은 다음과 같은 형태의 합에 해당합니다.
$$ (f * g)(x)= f(1) \cdot g(x-1) + f(2) \cdot g(x-2) + \dots + f(k) \cdot g(x - k) $$ 더 좁은 의미에서, 합성곱은 다항식을 곱한 결과입니다: $$ (A \cdot B)_k = a_0 \cdot b_k + a_1 \cdot b_{k-1} + \ldots + a_k \cdot b_0 $$즉, 결과의 $k$번째 계수는 $B(x)$의 계수로 주어지는 어떤 윈도 함수를 $A(x)$의 계수에 적용한 값과 같습니다. 따라서 이러한 함수는 행렬 곱셈을 통해 빠르게 계산할 수 있습니다.
예를 들어, 이 방법으로 문자열 $s$에서 비트 부분 문자열 $t$를 (비효율적으로) 찾을 수 있습니다. $s$의 문자들을 다항식 $A(x)$의 계수로, $t$의 문자들을 역순으로 다항식 $B(x)$의 계수로 쓰고 두 다항식을 곱합시다. 결과 다항식에서 계수가 $|t|$와 같은 위치에서 문자열 $t$가 $s$에 출현합니다.
또한 이 트릭을 이용하면 다른 문제도 풀 수 있습니다. 예를 들어 «fuzzy searching»을 수행할 수 있는데, $(|t|-d)$와 같은 계수는 정확히 $d$개의 오류가 있는 출현에 해당합니다.