고속 푸리에 변환은 20세기에 가장 중요한 알고리즘은 아니더라도 가장 중요한 알고리즘 중 하나입니다.
짐작할 수 있듯이, 이 알고리즘은 푸리에 변환을 계산하는 데 사용되며, 푸리에 변환은 다시 음향 처리, 전자기파, 광학 문제, 데이터 압축, 물리 시뮬레이션을 비롯한 여러 복잡한 수학 및 물리 문제에 활용됩니다.
이 글에서는 조금 다른 방향에서 접근하여, 올림피아드에서 자주 등장하는 수와 다항식의 곱셈 문제라는 맥락에서 고속 푸리에 변환 알고리즘을 살펴보겠습니다.
#보간을 통한 곱셈
$(n - 1)$차 다항식은 계수뿐만 아니라 서로 다른 $n$개의 점에서의 값으로도 유일하게 정의할 수 있습니다.
계수로 주어진 다항식을 직접 곱하려면 $O(n^2)$번의 연산이 필요합니다. 하지만 다항식이 $2n$개의 점에서의 값으로 주어진다면 $O(n)$에 곱할 수 있습니다. 곱 다항식 $A(x) \cdot B(x)$의 점 $x_i$에서의 값은 단순히 $A(x_i) \cdot B(x_i)$와 같아지기 때문입니다.
알고리즘의 핵심 아이디어는 다음과 같습니다. 두 다항식 $A$와 $B$에 대해 서로 다른 어떤 $(n + m)$개의 점에서 값을 계산하면, 이를 쌍마다 곱하여 $O(n + m)$번의 연산으로 같은 점들에서 다항식 $A(x) \cdot B(x)$의 값을 얻을 수 있고, 이 값들을 이용해 보간으로 곱 다항식의 계수를 구하여 문제를 해결할 수 있습니다.
vector<int> poly_multiply(vector<int> a, vector<int> b) {
    vector<int> A = evaluate(a);
    vector<int> B = evaluate(b);
    for (int i = 0; i < A.size(); i++)
        A[i] *= B[i];
    return interpolate(A);
}
evaluate와 interpolate가 선형 시간에 작동한다고 가정하면, 이러한 곱셈 역시 선형 시간에 작동할 것입니다. 그러나 안타깝게도 값을 직접 계산하려면 $O(n^2)$번의 연산이 필요하며, 보간은 가우스 소거법을 쓰든 라그랑주 다항식을 기호적으로 계산하든 그보다 더 많은 $O(n^3)$이 필요합니다.
하지만 점에서의 값을 계산하는 것과 보간을 더 빠르게 할 수 있다면 어떻겠습니까? 임의의 점이 아니라 특별한 점들, 즉 복소수 단위근만을 고려한다면 이것이 가능하다는 것이 밝혀졌습니다.
#단위근
사실. 임의의 자연수 $n$에 대하여 정확히 $n$개의 «1의 거듭제곱근», 즉 다음을 만족하는 수 $w_k$가 존재합니다.
$$ w_k^n = 1 $$ 구체적으로, 이 수들은 다음과 같은 꼴입니다. $$ w_k = e^{i \tau \frac{k}{n}} $$여기서 $\tau$는 $2 \pi$, 즉 “한 바퀴 전체"를 나타냅니다. 이는 꽤 새로운 표기법입니다.
복소평면에서 이 수들은 단위원 위에 서로 같은 간격으로 놓입니다:
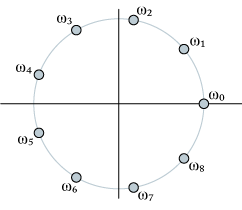
첫 번째 근 $w_1$(정확히는 두 번째 근입니다. 1을 0번째 근으로 보기 때문입니다)을 1의 $n$제곱 원시근이라고 부릅니다. 이를 0제곱, 1제곱, 2제곱 등으로 거듭제곱하면 필요한 1의 거듭제곱근의 수열이 생성되며, 이때 수열은 $n$번째 원소에서 순환합니다:
$$ w_n = e^{i \tau \frac{n}{n}} = e^{i \tau} = e^{i \cdot 0} = w_0 = 1 $$앞으로 $w_1$을 간단히 $w$로 표기하겠습니다.
#이산 푸리에 변환
다항식의 값을 복소수 단위근에서 계산하는 것을 바로 이산 푸리에 변환이라고 합니다:
$$ y_j = \sum_{k=0}^{n-1} x_k e^{i\tau \frac{kj}{n}} = \sum_{k=0}^{n-1} x_k w_1^{kj} $$짐작할 수 있듯이, 역 이산 푸리에 변환은 그 반대 연산, 즉 값 $y_i$로부터 계수 $x_i$를 보간하는 연산을 말합니다.
명제. 역 DFT는 다음 공식으로 계산할 수 있습니다.
$$ x_j = \frac{1}{n} \sum_{k=0}^{n-1} y_k e^{-i\tau \frac{kj}{n}} = \frac{1}{n} \sum_{k=0}^{n-1} y_k w_{n-1}^{kj} $$ 증명. 푸리에 변환을 계산할 때 우리는 사실상 벡터에 행렬을 적용하는 것입니다: $$ \begin{pmatrix} w^0 & w^0 & w^0 & w^0 & \dots & w^0 \\ w^0 & w^1 & w^2 & w^3 & \dots & w^{-1} \\ w^0 & w^2 & w^4 & w^6 & \dots & w^{-2} \\ w^0 & w^3 & w^6 & w^9 & \dots & w^{-3} \\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots \\ w^0 & w^{-1} & w^{-2} & w^{-3} & \dots & w^1 \end{pmatrix} \begin{pmatrix} a_0 \\ a_1 \\ a_2 \\ a_3 \\ \vdots \\ a_{n-1} \end{pmatrix} = \begin{pmatrix} y_0 \\ y_1 \\ y_2 \\ y_3 \\ \vdots \\ y_{n-1} \end{pmatrix} $$즉, 푸리에 변환은 벡터에 대한 선형 연산일 뿐입니다: $W a = y$. 따라서 역변환은 다음과 같이 쓸 수 있습니다: $a = W^{-1}y$.
이 $W^{-1}$은 어떤 모습일까요? 저자는 이것을 얻는 논리적인 추론 과정을 보여 주려 하지 않고 바로 제시하겠습니다:
$$ W^{-1} = \dfrac 1 n \begin{pmatrix} w^0 & w^0 & w^0 & w^0 & \dots & w^0 \\ w^0 & w^{-1} & w^{-2} & w^{-3} & \dots & w^{1} \\ w^0 & w^{-2} & w^{-4} & w^{-6} & \dots & w^{2} \\ w^0 & w^{-3} & w^{-6} & w^{-9} & \dots & w^{3} \\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots \\ w^0 & w^{1} & w^{2} & w^{3} & \dots & w^{-1} \end{pmatrix} $$$W$와 $W^{-1}$을 곱하면 실제로 단위 행렬이 되는지 확인해 봅시다:
- $i$번째 대각 원소의 값은 $\frac{1}{n} \sum_k w^{ki} w^{-ki} = \frac{1}{n} n = 1$입니다.
- 임의의 비대각($i \neq j$) 원소 $(i, j)$의 값은 다음과 같습니다
마지막 변환이 성립하는 이유는 모든 복소수 근의 합이 0이기 때문입니다. 즉, $\sum w^k = 0$입니다.
주의 깊은 독자라면 $W$와 $W^{-1}$의 형태, 그리고 정변환과 역변환 공식이 서로 대칭이라는 점을 눈치챌 것입니다. 이 대칭성 덕분에 일이 훨씬 수월해집니다. 역 푸리에 변환에도 같은 알고리즘을 사용할 수 있으며, $w^k$ 대신 $w^{-k}$를 사용하고 마지막에 결과를 $n$으로 나누기만 하면 됩니다.
#알고리즘
처음에 우리는 다음 알고리즘으로 다항식을 곱하려고 했다는 점을 다시 떠올려 봅시다.
- 두 다항식의 값을 임의의 $(n+m)$개 점에서 계산합시다.
- 이 값들을 $O(n + m)$에 쌍별로 곱합시다.
- 보간을 통해 곱 다항식을 얻습니다.
일반적인 경우에는 보간을 빠르게 계산하는 것은 물론이고 단순히 여러 점에서의 값을 계산하는 것조차 빠르게 할 수 없지만, 1의 거듭제곱근에 대해서는 가능합니다. 거듭제곱근에서의 값을 빠르게 계산하고 보간하는 방법(푸리에 변환과 역변환)을 익힌다면, 원래 문제를 풀 수 있습니다.
이에 해당하는 알고리즘을 고속 푸리에 변환(영어: fast Fourier transform)이라고 합니다. 이 알고리즘은 ‘분할 정복’ 패러다임을 사용하며 $O(n \log n)$ 시간에 동작합니다.
#쿨리-튜키 방식
일반적으로 분할 정복 알고리즘은 문제를 두 절반, 즉 처음 $\frac{n}{2}$개의 원소와 나머지 $\frac{n}{2}$개의 원소로 나눕니다. 하지만 여기서는 다르게 하겠습니다. 모든 원소를 짝수 번째와 홀수 번째로 나눕니다.
다항식을 $P(x)=A(x^2)+xB(x^2)$ 꼴로 나타냅시다. 여기서 $A(x)$는 $x$의 짝수 차수 항의 계수들로 이루어지고, $B(x)$는 홀수 차수 항의 계수들로 이루어집니다.
$n = 2k$라고 합시다. 그러면 임의의 정수 $t$에 대해 다음이 성립함에 주목합시다.
$$ w^{2t} = w^{2t \bmod n} = w^{2t \bmod 2k} = w^{2(t \bmod k)} $$ 이를 이용하면 점 $w^t$에서의 다항식의 값에 대한 원래 공식을 다음과 같이 쓸 수 있습니다: $$ P(w^t) = A(w^{2t}) + w^t B(w^{2t}) = A\left(w^{2(t\bmod k)}\right)+w^tB\left(w^{2(t\bmod k)}\right) $$핵심적인 관찰은 다음과 같습니다. 다시 계산하는 데 필요한 $w^{2t}$ 꼴의 서로 다른 근의 개수가 절반으로 줄어들고, 두 다항식의 계수도 각각 절반으로 줄어듭니다. 즉, 우리는 방금 문제를 각각 크기가 절반인 두 개의 문제로 성공적으로 나누었습니다.
알고리즘 자체는 다음과 같습니다. 다항식 $A$와 $B$에 대해 재귀적으로 FFT를 계산하고, 위의 공식을 이용해 결과를 합칩니다. 이때 재귀에서는 $n$차가 아니라 $k = \frac{n}{2}$차 단위근에서의 값을 계산해야 합니다. 즉, $n$차 단위근 중 모든 «짝수 번째» 근(형태 $w^{2t}$)에서의 값을 계산해야 합니다. $w$가 $n = 2k$차 원시 단위근이라면 $w^2$는 $k$차 원시 단위근이 된다는 점에 주목하십시오. 즉, 재귀 호출에는 원시근의 값만 바꾸어 넘겨주면 됩니다.
이와 같이 크기 $n$의 변환을 크기 $\dfrac n 2$의 변환 두 개로 줄였으므로, FFT의 전체 계산 시간은 다음과 같습니다
$$ T(n)=2T\left(\dfrac n 2\right)+O(n)=O(n\log n) $$또한 $n$이 $2$로 나누어떨어진다는 가정이 중요한 역할을 했다는 점에 주목하십시오. 따라서 $n$은 마지막 단계를 제외한 모든 단계에서 짝수여야 하며, 이로부터 $n$이 2의 거듭제곱이어야 함을 알 수 있습니다.
#구현
쿨리-튜키 방식으로 FFT를 계산하는 코드를 제시합니다:
typedef complex<double> ftype;
const double pi = acos(-1);

// принимает массив и n-ный корень из единицы, и заменяет его на значения в корнях
void fft(vector<ftype> &p, ftype wn) {
    int n = (int) p.size();
    if (n == 1)
        return;
    // разделяем массив на четный и нечетный
    vector<ftype> a(n / 2), b(n / 2);
    for (int i = 0; i < n / 2; i++) {
        a[i] = p[2 * i];
        b[i] = p[2 * i + 1];
    }
    // рекурсивно считаем БПФ
    fft(a, wn * wn);
    fft(b, wn * wn);
    // объединяем результат по формуле
    ftype w = 1;
    for (int i = 0; i < n / 2; i++) {
        // можно не использовать модуль, а сразу раскрыть его для двух половин
        p[i] = a[i] + w * b[i];
        p[i + n / 2] = a[i] - w * b[i]; // w^(i+n/2) = -w^i
        w *= wn;
    }
}
처음 실행할 때에는 배열을 2의 거듭제곱 크기가 되도록 채워야 합니다:
vector<ftype> evaluate(vector<int> p) {
    while (__builtin_popcount(p.size()) != 1)
        p.push_back(0);
    return fft(p, polar(1., 2 * pi / p.size()));
}
앞서 논의했듯이, 역 푸리에 변환은 순방향 변환을 이용해 편리하게 표현할 수 있습니다:
vector<int> interpolate(vector<ftype> p) {
    int n = p.size();
    auto inv = fft(p, polar(1., -2 * pi / n));
    vector<int> res(n);
    for(int i = 0; i < n; i++)
        // мы хотим получать целые числа, для этого результаты нужно округлить
        res[i] = round(real(inv[i]) / n);
    return res;
}
이제 우리는 두 다항식을 $O(n \log n)$에 곱할 수 있습니다:
vector<int> poly_multiply(vector<int> a, vector<int> b) {
    vector<ftype> A = evaluate(a);
    vector<ftype> B = evaluate(b);
    for (int i = 0; i < A.size(); i++)
        A[i] *= B[i];
    return interpolate(A);
}
위의 코드는 올바르며 $O(n \log n)$의 점근적 복잡도를 갖지만, 주로 재귀와 추가적인 메모리 할당 때문에 상수가 상당히 큽니다.
#최적화된 버전
할당을 아예 없애 봅시다. 지금은 매번 배열을 둘로 나누기 때문에 할당이 발생합니다. 새 배열을 만드는 대신 짝수 번째 원소를 모두 왼쪽 절반으로, 홀수 번째 원소를 모두 오른쪽 절반으로 옮긴 다음 각 절반에 대해 재귀적으로 실행하면 어떻게 됩니까?
관찰. 재귀의 마지막 단계에서 인덱스가 k인 원소는 revbits(k)번 칸에 기록됩니다. 여기서 revbits(x) 함수는 수 x의 비트를 ‘뒤집는’ 함수입니다.
실제로 첫 번째 반복에서 모든 짝수 원소(최하위 비트가 0인 원소)는 앞쪽 절반(최상위 비트가 0인 위치)에 기록되고, 홀수 원소는 그 반대입니다. 다음으로, 두 번째로 낮은 비트가 0인 모든 원소는 각자의 절반 안에서 더 작은 쪽 절반(두 번째로 높은 비트가 0인 쪽)에 기록되며, 이후로도 마찬가지입니다.
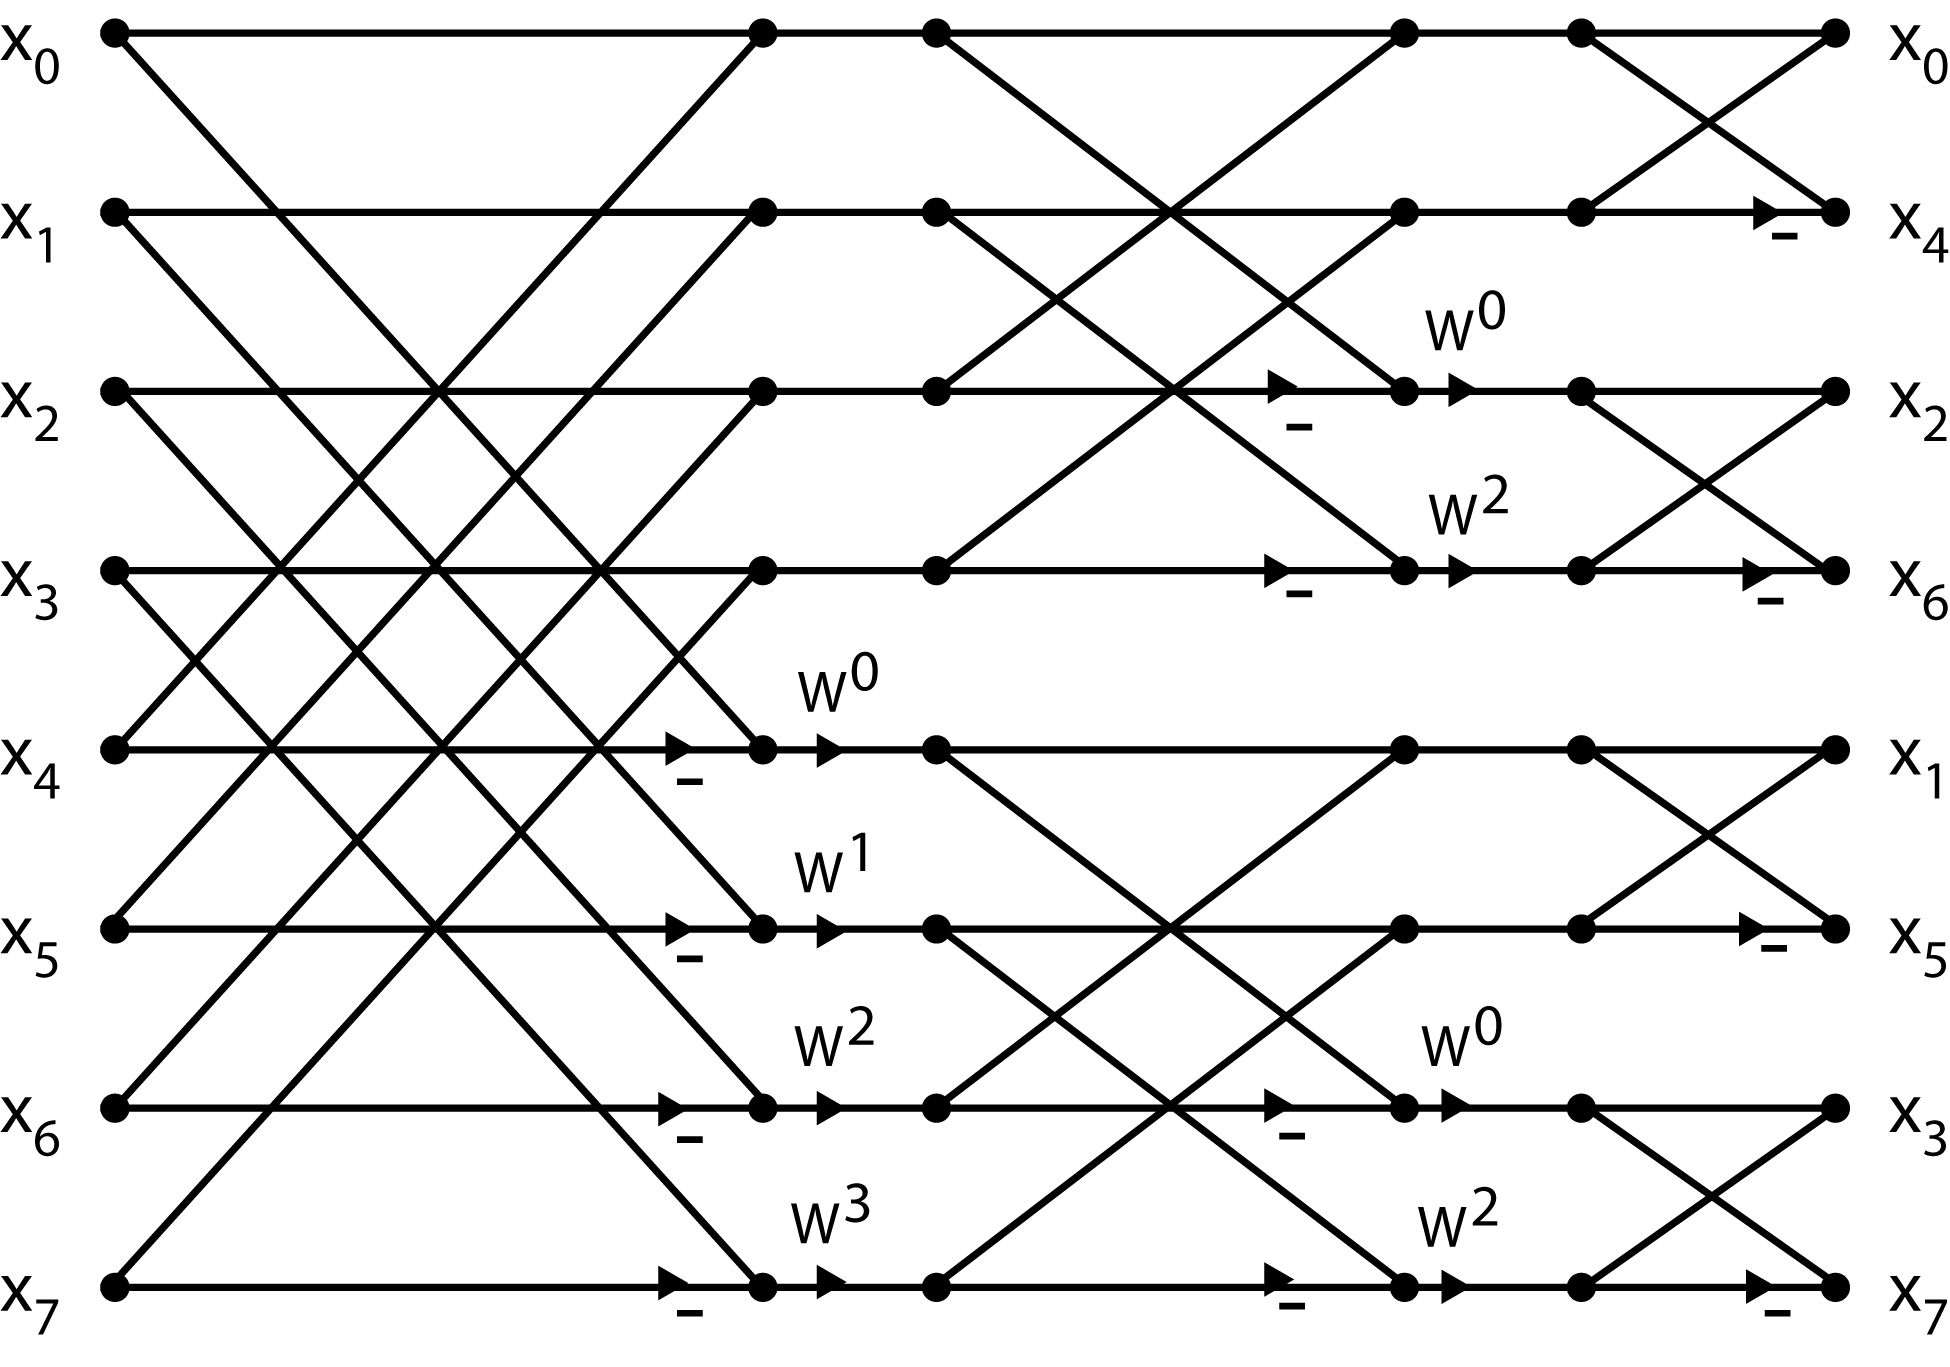
각 원소가 어디에 놓이게 될지 알고 있다면, 재귀 내부에서는 아예 어떠한 재배치도 하지 말고 맨 처음에 한 번만 수행한 다음, 재귀 함수에서는 그저 절반들에 대해서만 호출하도록 합시다.
void solve(ftype *a, int n, ftype wn) {
    if (n > 1) {
        int k = (n >> 1);
        solve(a, k, wn * wn);
        solve(a + k, k, wn * wn);
        ftype w = 1;
        for (int i = 0; i < k; i++) {
            // тут нужно быть чуть аккуратней с перезаписыванием,
            // потому что мы читаем и пишем из одного и того же массива
            ftype t = w * a[i + k];
            a[i + k] = a[i] - t;
            a[i] = a[i] + t;
            w *= wn;
        }
    }
}

void fft(ftype *a, int n, int inverse) {
    const int logn = __lg(n);

    for (int i = 0; i < n; i++) {
        // переворачиваем биты числа i
        int k = 0;
        for (int l = 0; l < logn; l++)
            k |= ((i >> l & 1) << (logn - l - 1));
        // делаем только один swap -- из того элемента, который идет раньше
        if (i < k)
            swap(a[i], a[k]);
    }

    ftype wn = polar(1., inverse * 2 * pi / n); // inverse = {-1, +1}
    solve(a, n, wn);
}
이 알고리즘은 수치적 안정성이 꽤 좋은 편이지만, 올림피아드 문제에서는 큰 정수 답을 계산하거나 그 답을 어떤 수로 나눈 나머지를 구해야 하는 경우가 많습니다. 하지만 이 문제는 해결할 수 있습니다.
#정수론적 변환
사실 우리에게 필요했던 복소수의 성질은 단 하나, 1에 $n$개의 «근»이 존재한다는 것뿐입니다. 사실 복소수 외에도 이러한 성질을 갖는 다른 대수적 대상들이 있습니다. 예를 들어 어떤 법에 대한 잉여류환의 원소들이 그렇습니다.
$w_n^1$의 역할을 하는 $g$와 $m$의 쌍을 찾되, $g$가 생성원이 되도록, 즉 $g^n \equiv 1 \pmod m$이고 나머지 모든 $k < n$에 대해 거듭제곱 $g^k$가 $m$을 법으로 모두 서로 다르도록 합시다. 실제로는 $m$으로 일부러 ‘편리한’ 모듈러를 택하는 경우가 많습니다. 예를 들면 다음과 같습니다.
$$ m = 998244353 = 7 \cdot 17 \cdot 2^{23} + 1 $$이 수는 소수이며, 동시에 2의 큰 거듭제곱으로 나누어떨어지는 수보다 정확히 1만큼 큽니다. $n=2^{23}$일 때 적합한 $g$는 $31$입니다. 복소수의 경우와 마찬가지로, 어떤 $n=2^k$에 대해 원시근이 $g$라면 $n=2^{k-1}$에 대해서는 $(g^2 \bmod m)$이 원시근이 된다는 점에 주목하십시오. 따라서 $m=998244353$과 $n=2^k$에 대해 원시근은 $g=31^{2^{23-k}} \bmod m$이 됩니다.
이때 구현은 거의 차이가 없습니다. 모든 연산에서 모듈러 산술을 사용하고, $w$와 $w^{-1}$에 대해 미리 계산해 둔 무시무시한 상수를 사용하기만 하면 됩니다.
또한 최근에는 일부 출제자들이 문제가 FFT 문제임을 암시하기 위해(또는 혼란을 주기 위해) 표준적인 $10^9+7$ 대신 바로 이 모듈러를 사용하기 시작했습니다.